Описание
Когда пользователь спрашивает у нейросети «что выбрать», он получает не список ссылок, а готовую рекомендацию. Бренд в ней либо есть, либо нет, и обычные SEO-метрики этого не показывают. АЙNET Радар измеряет именно это: как бренд выглядит в ответах ChatGPT, Gemini, DeepSeek, GigaChat и Алисы глазами реального пользователя, а не в технической среде API. Сервис позволяет проверить присутствие бренда в нейровыдаче, сравнить его показатели с рынком и найти точки роста в ИИ-поиске.
Контекст и проблема
Для выстраивания GEO-стратегии необходимо анализировать ответы ИИ-систем, частоту и тональность упоминаний бренда, его положение относительно конкурентов и источники, на которые опирается ИИ. Результат при этом зависит от запроса, модели и информационного контекста, который система использует для формирования ответа.
Поисковое поведение пользователей изменилось, и видимость в нейросетях стала отдельным показателем для бизнеса. Можно сформулировать запрос о выборе продукта или услуги и получить готовую рекомендацию вместо списка ссылок. Потенциальный клиент способен принять решение, не переходя на страницу продукта. Поэтому компаниям важно понимать, насколько часто они присутствуют в таких ответах и какие факторы на это влияют.
Многие GEO-сервисы собирают данные из нейросетей через API моделей. Но API показывает, как модель отвечает в технически заданной среде, а не то, что видит человек в веб-интерфейсе или приложении. В нашем тесте расхождение между API и «живой» выдачей достигало 74 п.п.
|
Показатель |
По API: как модель отвечает в технически заданной среде |
Вживую: что реально видит пользователь в интерфейсе LLM |
|---|---|---|
|
Близость к реальному пользователю |
Средняя |
Максимальная |
|
Поиск актуальной информации |
Не у всех LLM (нет у DeepSeek, GigaChat, Алисы) |
Есть |
|
Что измеряем |
Ответ API-модели с параметрами |
Ответ реального пользователя |
|
Результаты выдачи |
Могут отличаться от web/app версии |
Реальные ответы |
|
Скорость |
Высокая |
Низкая |
|
Техническая сложность |
Низкая |
Высокая |
Вторая проблема — волатильность. При повторных замерах в течение суток видимость одного и того же бренда в Яндекс Алисе (100 запросов) колебалась от 31% до 45%, среднее — 38%. Решения, принятые по одному разовому съёму, рискуют опираться на случайный выброс.
Третья проблема — привычка смотреть на среднюю позицию, как в топ-10 поисковой выдачи. В ответе нейросети число рекомендуемых брендов непредсказуемо (3, 5 или 8), и без поправки на него средняя позиция вводит в заблуждение: пятое место в ответе из пяти брендов означает «всегда последний», а не «хорошая позиция».
Четвёртая проблема — конкуренты. Список конкурентов обычно задают вручную, а нейросеть может считать конкурентами совсем других игроков.
Разработка АЙNET Радар стала ответом на внутреннюю потребность агентства. Мы выяснили, что большинство предложений на рынке выдаёт разные данные по одинаковым запросам, а на верификацию уходило слишком много времени и ресурсов. Мы решили создать собственный контролируемый продукт с понятным механизмом работы. Его основа — гипотеза: достоверная аналитика требует измерять пользовательский опыт («живая» выдача из интерфейса LLM с Web-Search) и усреднять серию регулярных замеров.
Пользователь прописывает интересующие запросы (поиск услуги или продукта, сравнение решений, выбор поставщика, рекомендации, информационные вопросы), а система проверяет присутствие бренда в ответах нейросетей. Результаты собираются в аналитический отчёт.
Четыре ключевые особенности сервиса:
-
Сбор данных напрямую из интерфейсов LLM. Ответы получаем через пользовательские интерфейсы, так же, как это делает реальный пользователь.
-
Усреднение по нескольким замерам. Ответы LLM волатильны, поэтому мы проводим несколько замеров и считаем усреднённый результат.
-
Уникальные метрики. Ranking Score уточняет среднюю позицию с поправкой на переменное число брендов в ответе и показывает доверие ИИ к бренду. Лидер-индекс показывает отставание от лидера категории.
-
Анализ промптов. Конкурентов не нужно задавать заранее: система сама находит бренды, которые чаще всего упоминаются в ответах, вплоть до конкретных продуктов.
Методология
АЙNET Радар закрывает четыре технологических барьера GEO-аналитики.
1. Сбор данных из живых интерфейсов
Сервис эмулирует поведение реального пользователя в интерфейсах ChatGPT, DeepSeek, GigaChat, Яндекс Алисы и Gemini, включая поиск актуальной информации в сети (Web-Search).
2. Усреднение волатильности
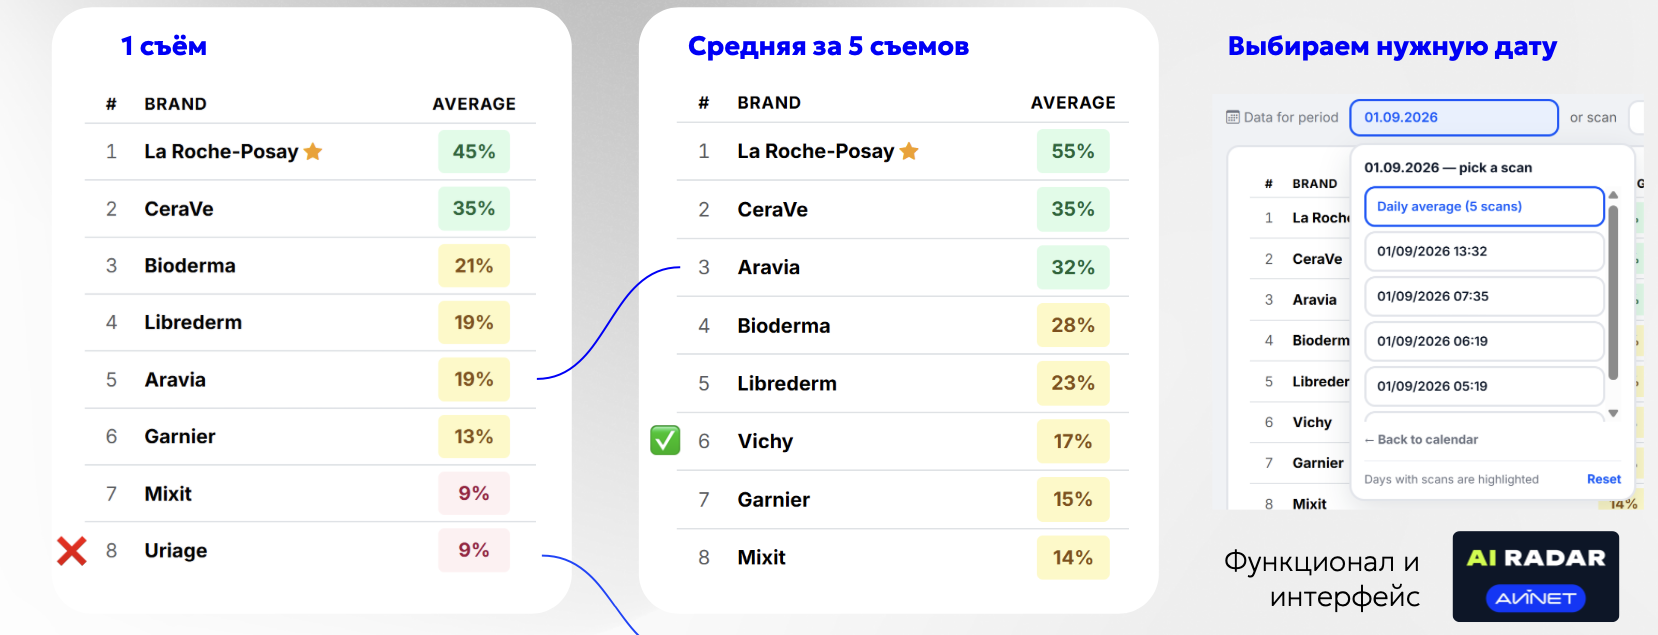
Система проводит серийные съёмы и рассчитывает усреднённую видимость за выбранную дату или период. Это сглаживает случайные выбросы. Любое количество съёмов усредняется автоматически, а любой день можно скрыть или дозапустить. Для достоверного среднего мы рекомендуем не менее трёх замеров.
3. Авторские метрики
В классическом SEO средняя позиция работает, потому что выдача устроена одинаково: топ-10 всегда топ-10. В ответе нейросети всё иначе: число рекомендуемых брендов непредсказуемо, в одном ответе их 3, в другом 5, в третьем 8. Привычная средняя позиция при таком разбросе почти ничего не говорит, потому что не учитывает, сколько всего брендов было в списке. Мы не заменяем среднюю позицию, а уточняем её с поправкой на то, что число брендов в ответе не фиксировано. Для этого сервис считает три метрики, каждая следующая опирается на предыдущую.
1. Position Score —
позиция бренда в одном ответе с учётом длины списка. Пример: бренд стоит 5-м в ответе из 5 брендов. Он последний в каждом таком ответе, хотя «средняя позиция 5» на привычный взгляд выглядит неплохо. А 5-е место в списке из 10 брендов — это середина. Position Score различает эти случаи:
|
Место в ответе |
Брендов в ответе |
Position Score |
Как читается |
|---|---|---|---|
|
1-е |
3 |
1,00 |
первый |
|
5-е |
10 |
0,60 |
середина списка |
|
5-е |
5 |
0,20 |
последний |
|
3-е |
3 |
0,33 |
последний |
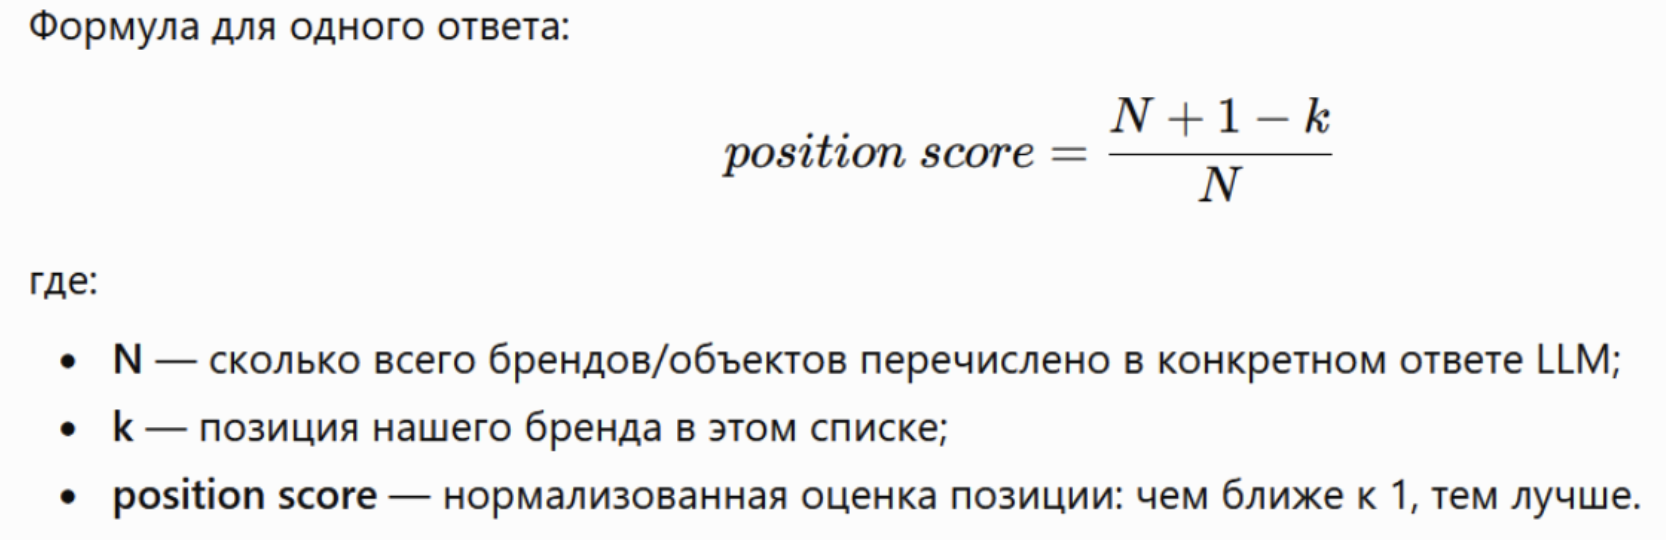
Position Score для одного ответа считается так:
2. Ranking Score —
среднее значение Position Score по всем ответам. Средняя позиция сама по себе не показательна, потому что в ответе может быть от 3 до 10 брендов. Ranking Score учитывает это и показывает, насколько высоко ИИ ставит бренд, когда его рекомендует.
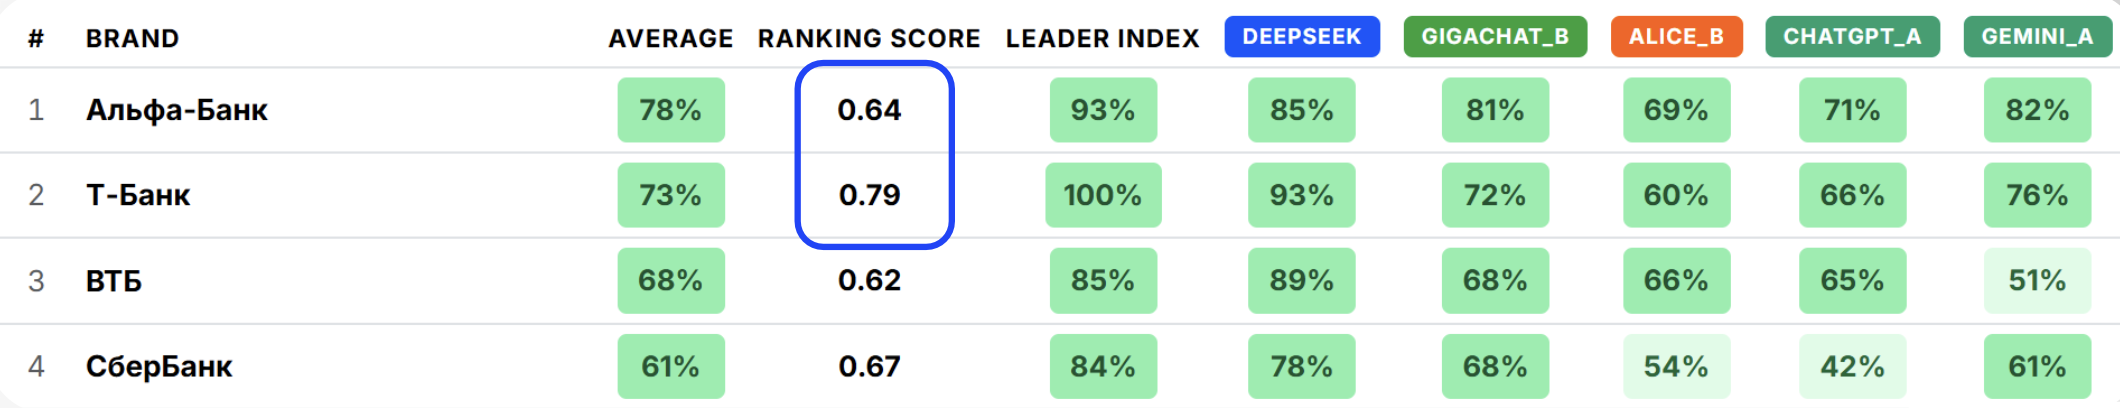
Пример: Альфа-Банк имеет наибольшую видимость среди банков в выборке (78%). Но когда ИИ рекомендует Т-Банк (видимость 73%), тот стоит в списке заметно выше: Ranking Score 0,79 против 0,64. Это косвенно говорит о большем доверии ИИ к Т-Банку.
3. Лидер-индекс
сравнивает бренд с лидером категории, учитывая и долю упоминаний, и позицию:
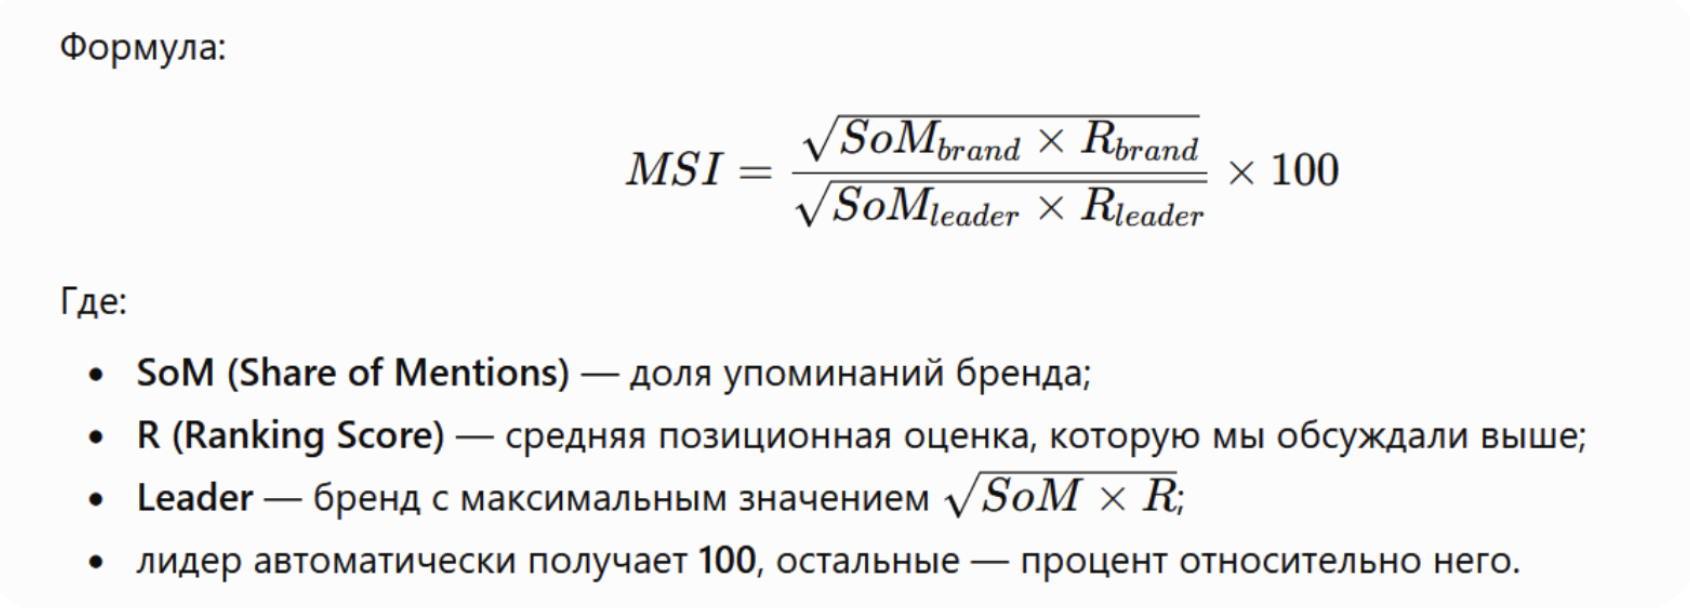
Пример из ниши детского питания: Нутрилак по видимости на шестом месте (29%), но его Ranking Score 0,69 — второй в нише после лидера Nutricia (0,85) и выше, чем у Nestle (0,62). Поэтому Лидер-индекс Нутрилака 52%, на уровне брендов с видимостью 32–36%.
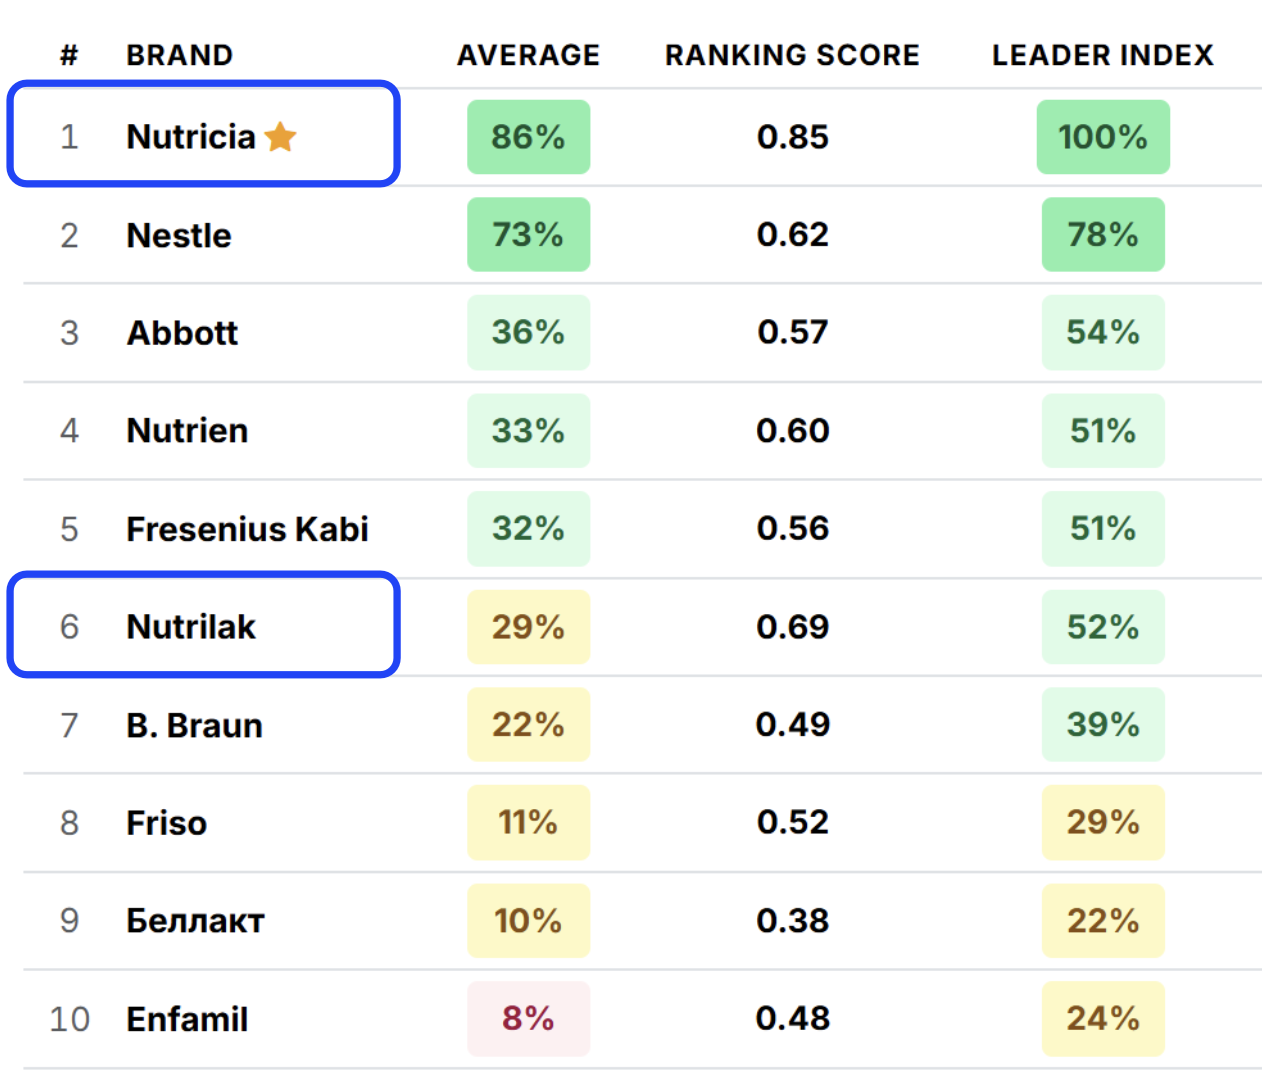
Nutricia — безусловный лидер по всем критериям, Нутрилак — сильно отстает по видимости. Однако если Нутрилак рекомендуется, то показывается выше остальных. Это компенсирует его отставание от лидера и говорит о большем доверии к бренду. Обычный рейтинг по упоминаниям этого бы не показал.
В примере с банками Т-Банк при меньшей видимости получает Лидер-индекс 100 и опережает Альфа-Банк (93).
4. Автоматическое выявление слепых зон
Сервис сам определяет бренды и конкретные продукты, упоминаемые в ответах ИИ, и исключает человеческий фактор при составлении пула конкурентов. В нише «Перхоть» мы вручную добавили более 40 конкурентов и всё равно пропустили Себозол (51% видимости) и Циновит (38%). Анализ ответов позволил их найти и добавить в отслеживание.
Что есть внутри сервиса
-
Обзор проектов. Проекты удобно группируются по папкам, упрощая навигацию. Также встроен поиск по проектам.
-
Сводная по проектам. Данные по последнему съему: видимость, ренкинг-скор, лидер-индекс. Есть возможность выбрать группу запросов.
-
Исторические данные по клиенту. Как менялась видимость в разные даты, доля какой LLM преобладает.
-
Динамика KPI. Возможность посмотреть показатели в динамике для своего клиента и конкурентов.
-
Общая видимость. Ключевые метрики по текущему клиенту и конкурентам в разрезе каждой LLM и средние показатели.
-
Усреднение волатильности. Вы можете выбрать интервал дат и рассчитать среднее за период. Это позволяет нивелировать волатильность.
-
Ответы нейросетей. Визуальное представление наличия ответов и возможно посмотреть каждый из них.
-
Самые популярные домены. Какие сайты чаще всего попадают в ответы нейросетей по вашим запросам.
-
Самые популярные страницы. Какие страницы чаще всего попадают в ответы нейросетей по вашим запросам.
-
Исторические данные. Возможность управлять данными за разные даты и отключать ненужные.
-
Функционал анализа нейроответов (Google AI Overviews и Яндекс Алиса в Поиске). Мы также снимаем данные по нейроответам, можем считать упоминание бренда или конкретного сайта.
Для каких задач используют
Первичный аудит позиции бренда в нейровыдаче, регулярный мониторинг, оценка изменений после публикаций и PR-кампаний, поиск групп запросов, где бренд систематически выпадает из рекомендаций, корректировка контентной стратегии.
В ИИ-поиске одной стабильной позиции фактически нет, важно смотреть на присутствие бренда сразу в десятках пользовательских сценариев и находить зоны, где компания системно выпадает из рекомендаций.
Результаты
Что показали замеры
|
Что проверяли |
Результат |
|---|---|
|
API и «живая» выдача |
В нише себорейного дерматита (ChatGPT, Gemini, GigaChat; Кетоконазол, Nizoral, Sebozol) расхождение достигло 74 п.п. GigaChat по Кетоконазолу: 13% через API и 87% в интерфейсе. По Sebozol: 7% и 60%. |
|
Волатильность |
Яндекс Алиса, 100 запросов: видимость от 31% до 45%, среднее 38%. |
|
Влияние усреднения |
В одном съёме Aravia на 5-м месте, в среднем за 5 съёмов — на 3-м. Vichy входит в топ-8, Uriage из него выпадает. |
|
Полнота конкурентов |
В нише «Перхоть» вручную заданы 40+ брендов; сервис дополнительно нашёл Себозол (51%) и Циновит (38%). |
|
Сравнение с аналогами |
На одних и тех же промптах результаты разных сервисов различались в 4 раза. |
Масштаб
Пример проекта в ритейле: 5 нейросетей, 2 400 ответов, 1 262 упоминания бренда, съём выполнен за 1 час 12 минут. Видимость бренда 54%, Ranking Score 0,72, Leader Index 93% относительно лидера категории.
Экономика
Ответ одной нейросети в АЙNET Радар стоит 2 рубля. Для сравнения: Pixel Tools, Rush Analytics и Keys.so — 3 рубля, Brandfound — 10 рублей.
Срез по узкой категории (5 нейросетей, 300 запросов, 3 съёма) обходится в 9 000 рублей. Срез по всей тематике (5 нейросетей, 1 000 запросов, 3 съёма) — в 30 000 рублей.
Значение для бизнеса
Сервис запущен недавно, поэтому в заявке мы не приводим выручку и число подключений. Эффект на сегодня другой: агентство перестало тратить время на сверку расхождений между сервисами, а клиенты получили KPI, которые можно проверить вручную по конкретному ответу нейросети. АЙNET Радар уже используется в аналитике для брендов из FMCG, фармы и ритейла (L'Oréal, Nutricia, Черноголовка и других) и даёт прозрачную долю голоса (Share of Mentions), позицию бренда и контроль над цитируемостью в ИИ.