Описание
Semantica AI — платформа видимости и репутации бренда в нейросетях: мониторинг ответов, конкуренты, факты, контент, публикация и замер цитирования.
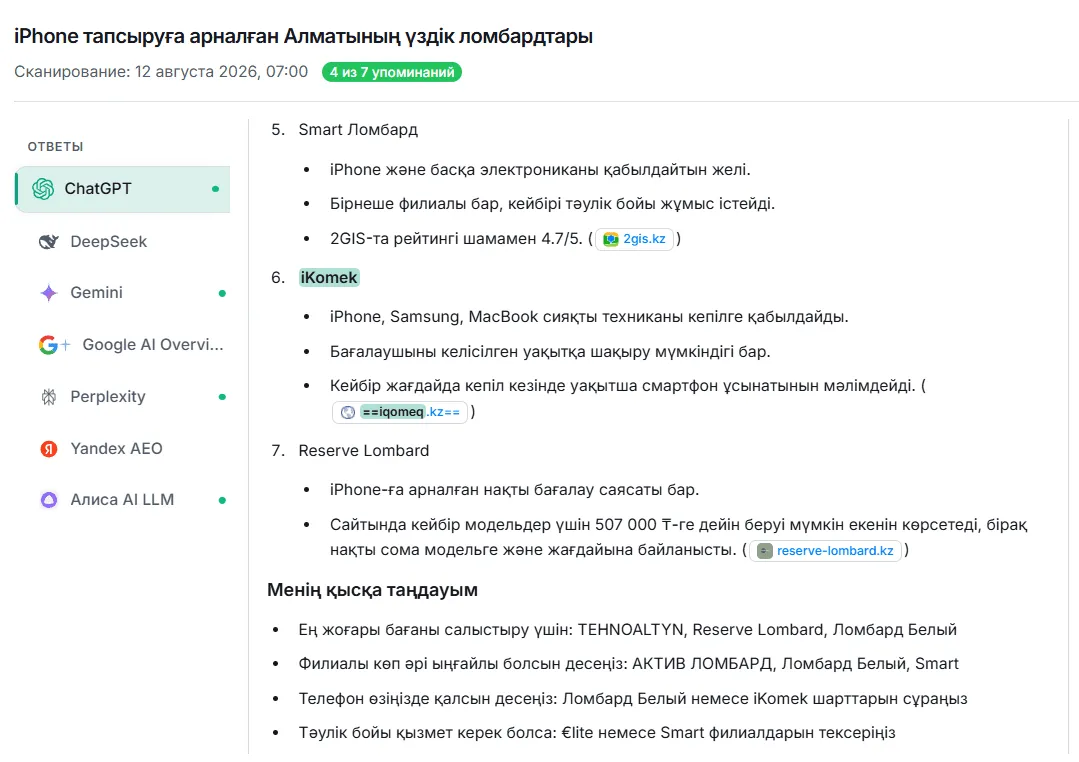
1. Один из ключевых слоёв платформы — MCP-сервер. Он даёт AI-агентам прямой доступ к проектам, сканам, метрикам, источникам, zero-click, тональности, Wordstat, Agent Ready и AI Commerce. Команда может исследовать данные и запускать рабочие сценарии прямо из AI-инструментов — без ручных выгрузок и постоянного переключения между сервисами. Скриншоты из ChatGPT
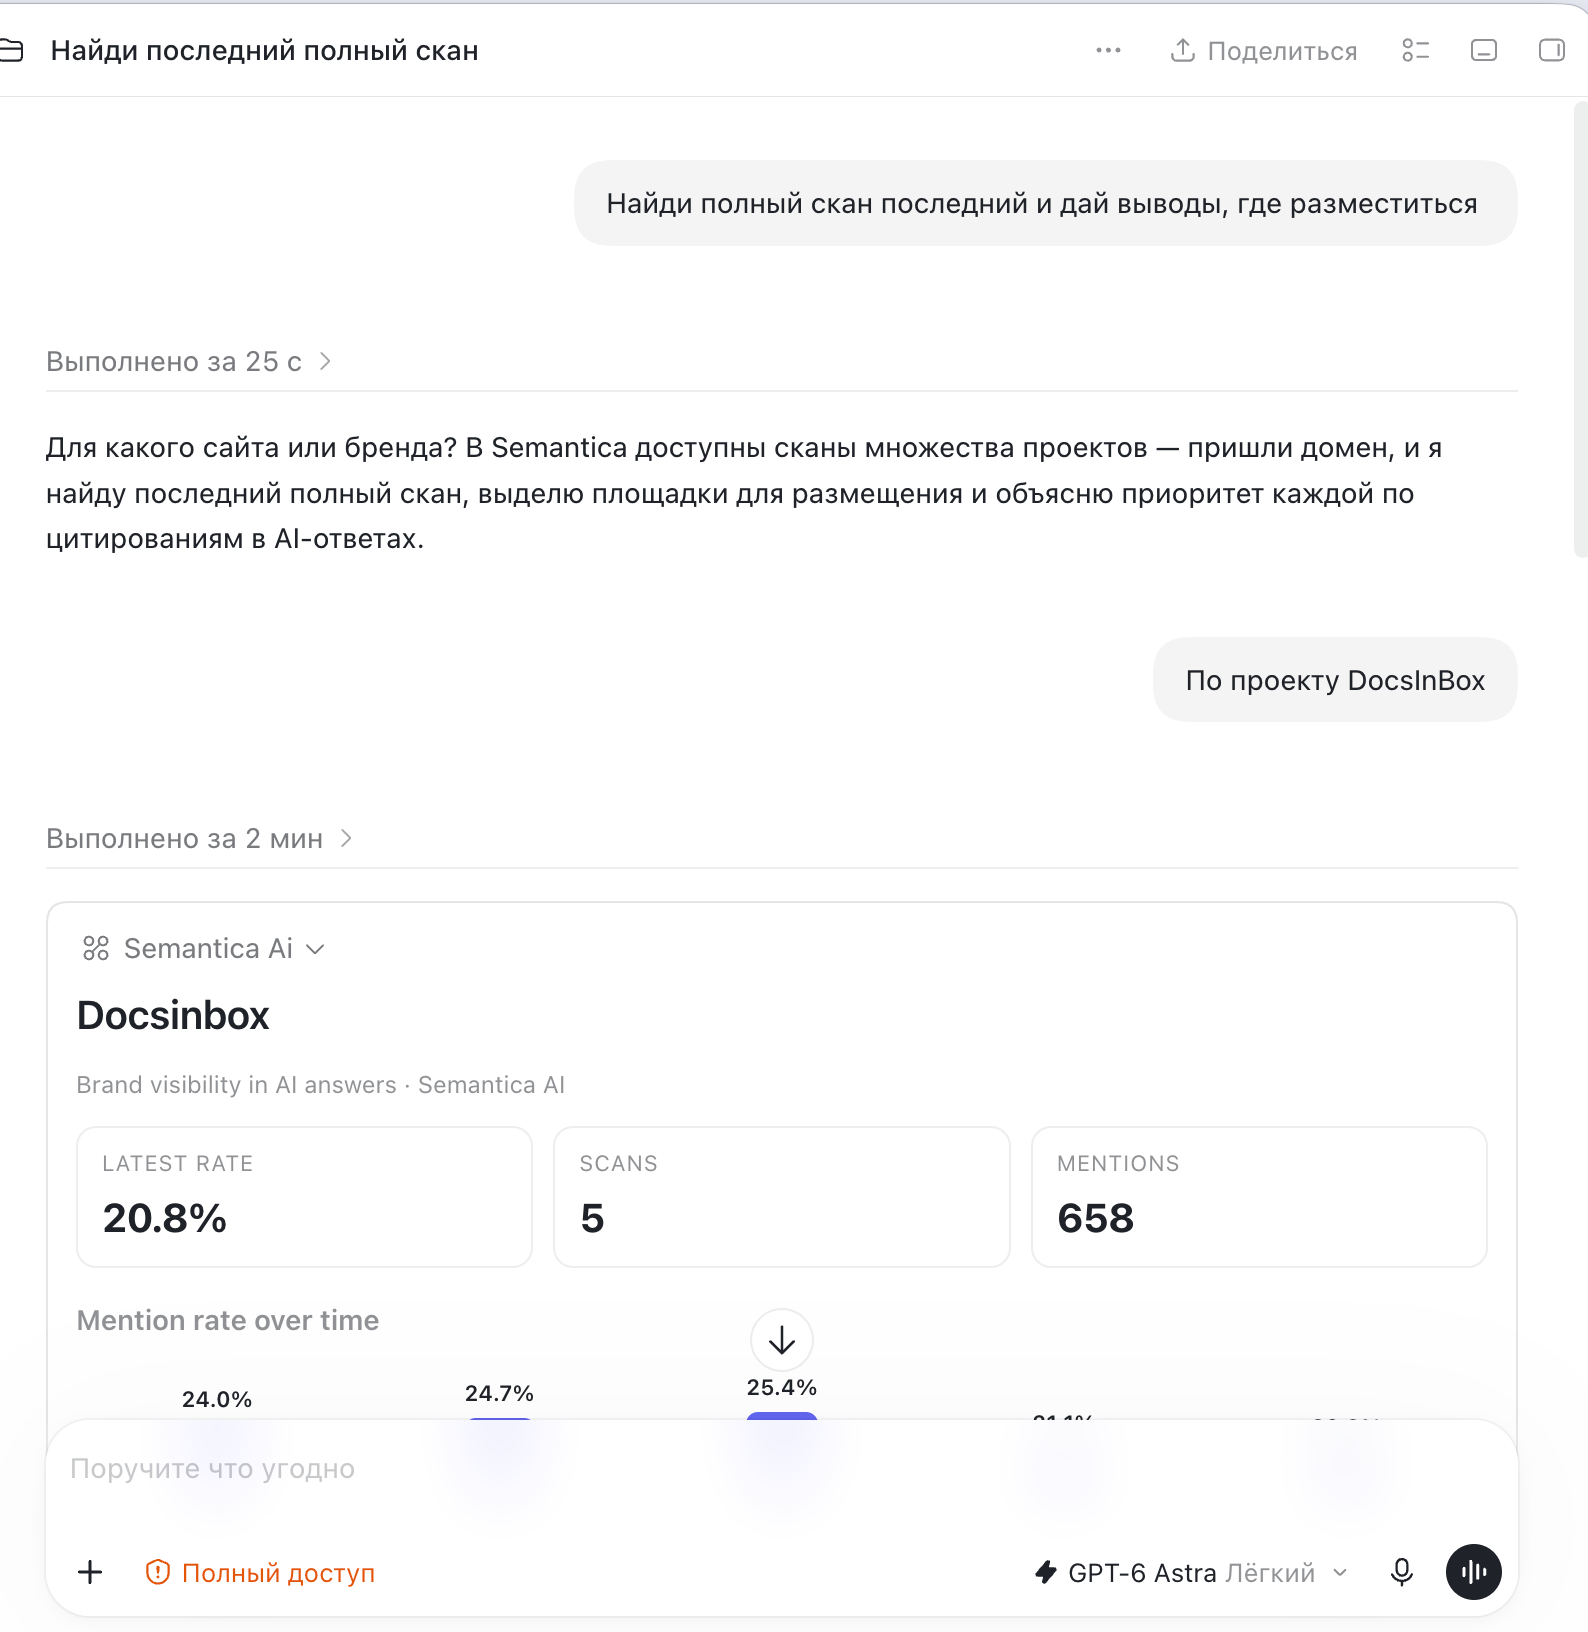
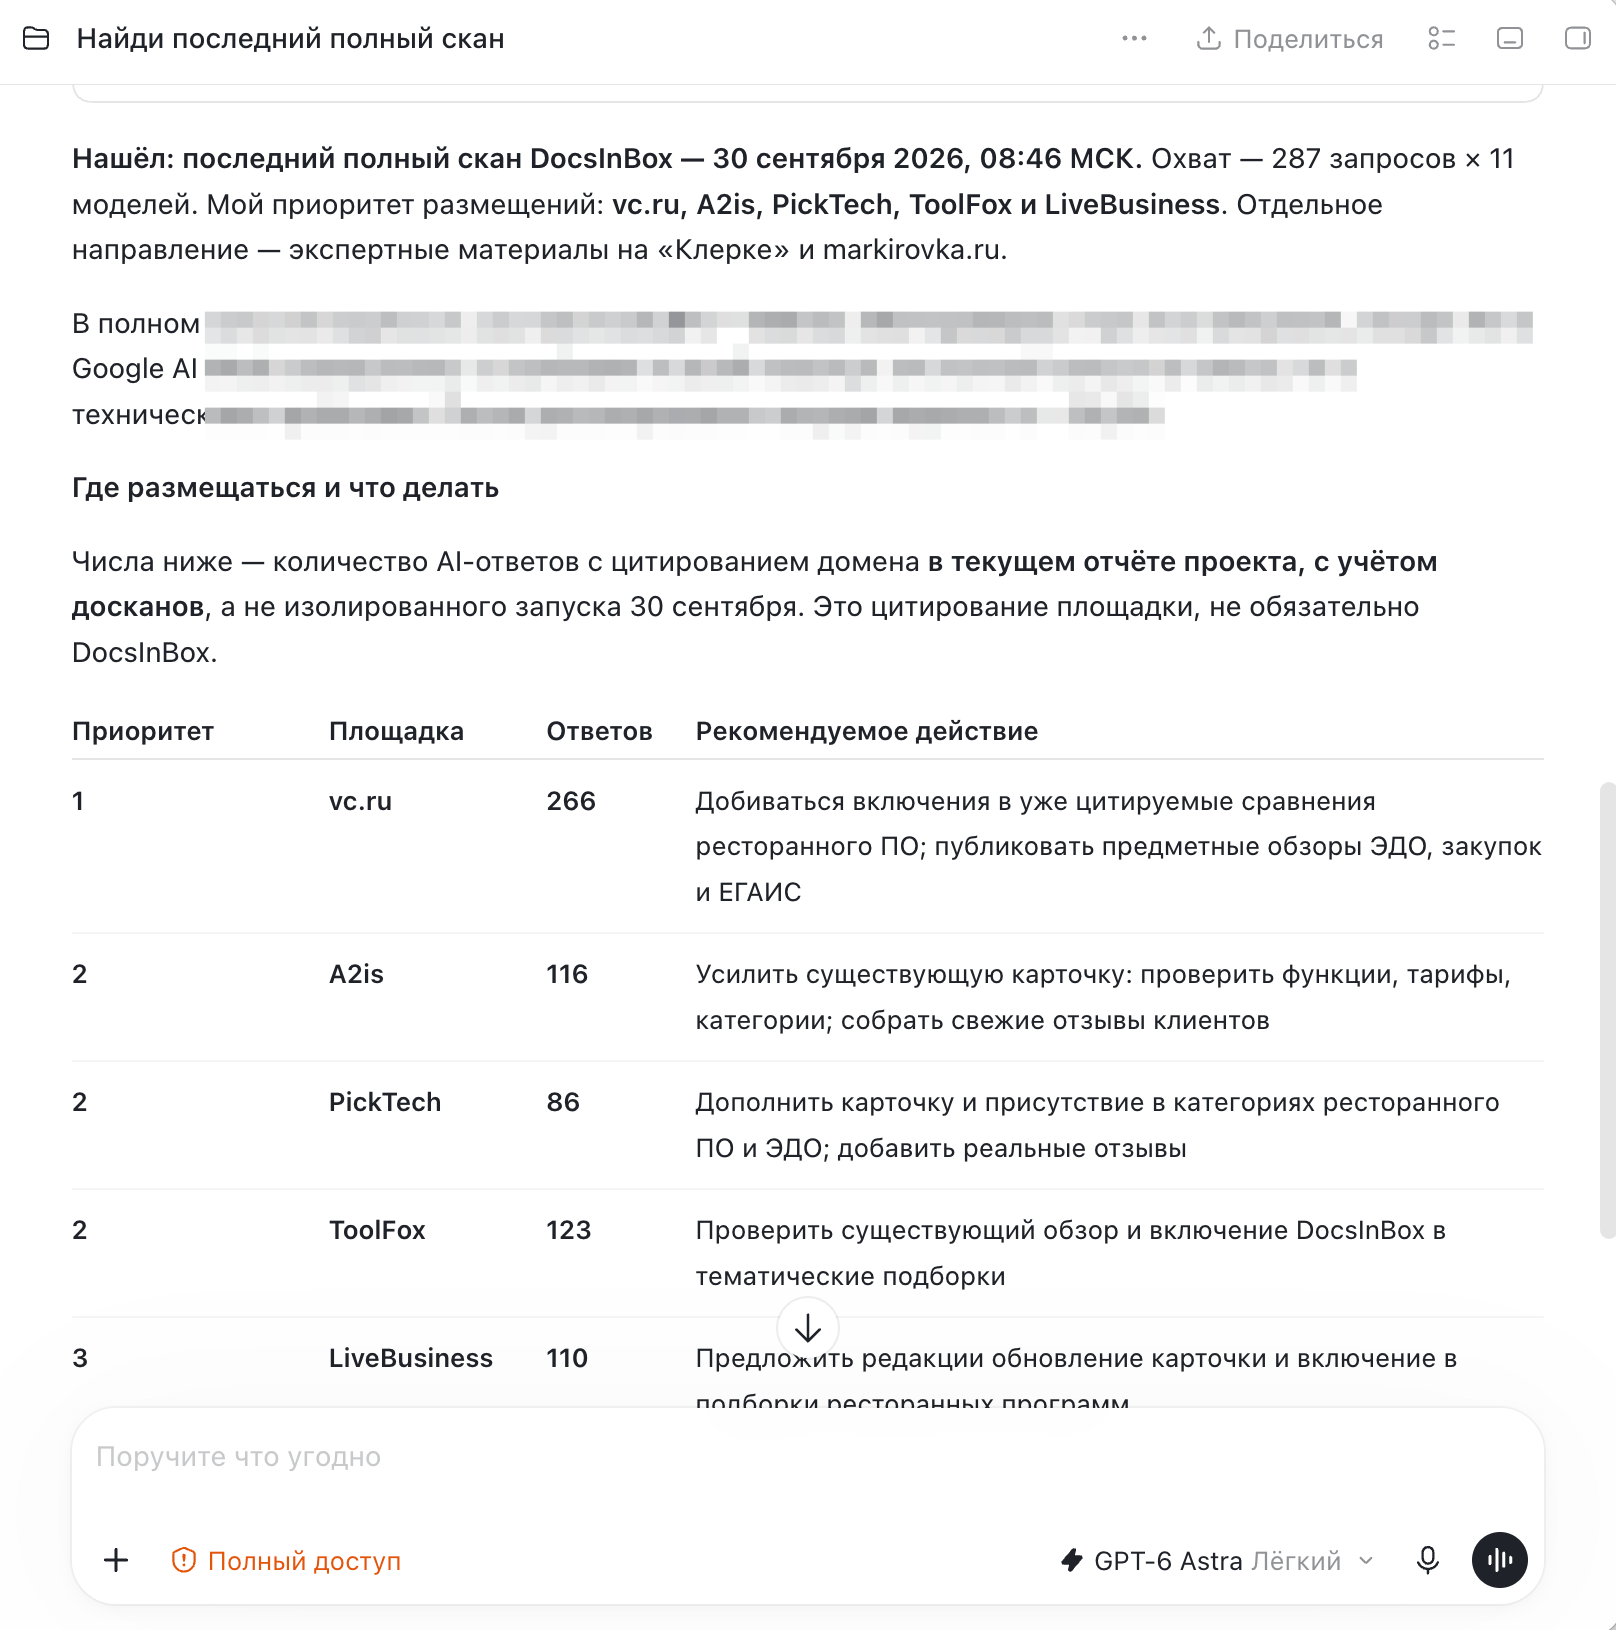
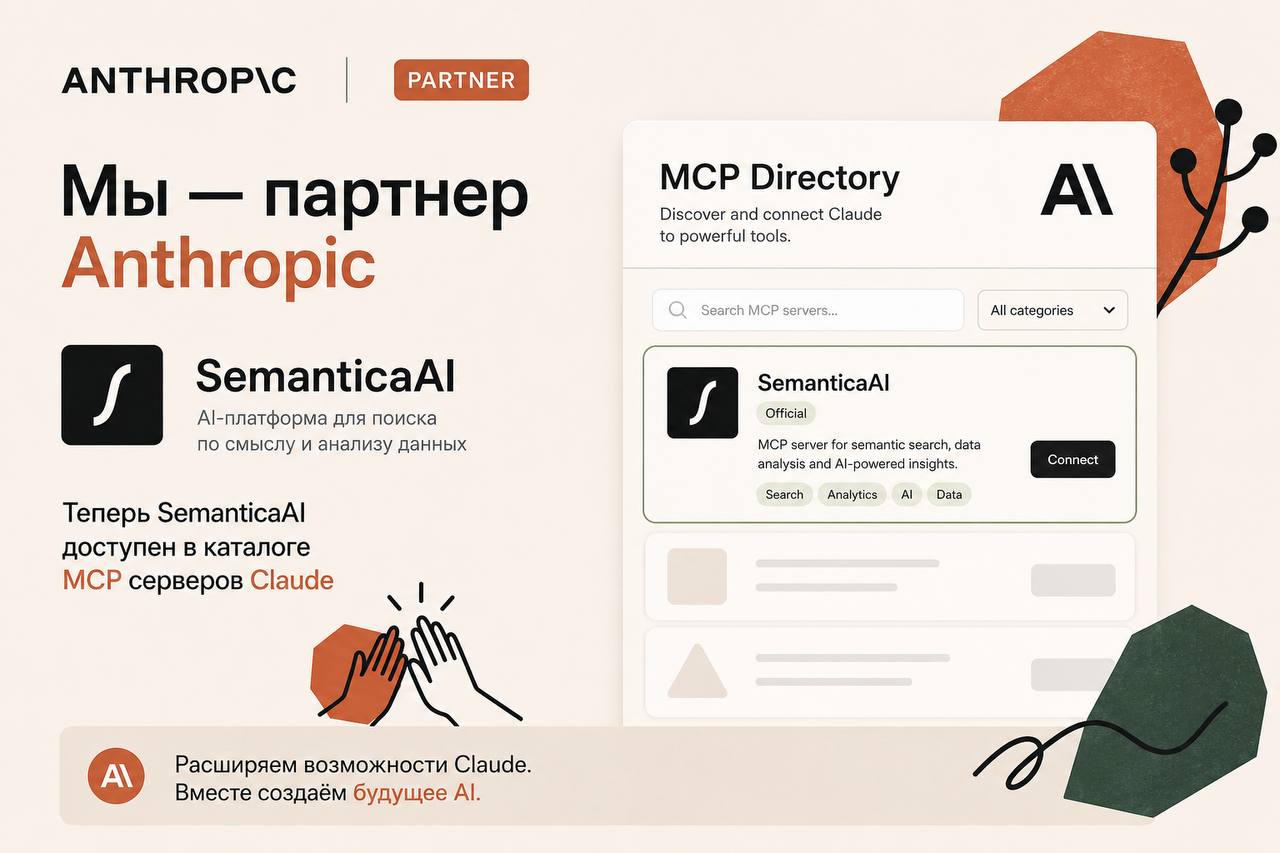
Это современный способ работы с GEO и SEO, при котором нейросеть не просто отвечает на вопросы, а действует на основе живых данных Semantica AI. MCP-сервер платформы опубликован в официальном каталоге Anthropic. Попадание туда - сложная работа, требующая соблюдения массы правил и проверок. По нашей информации, мы единственный в РФ GEO-сервис, кто добавлен в каталог.
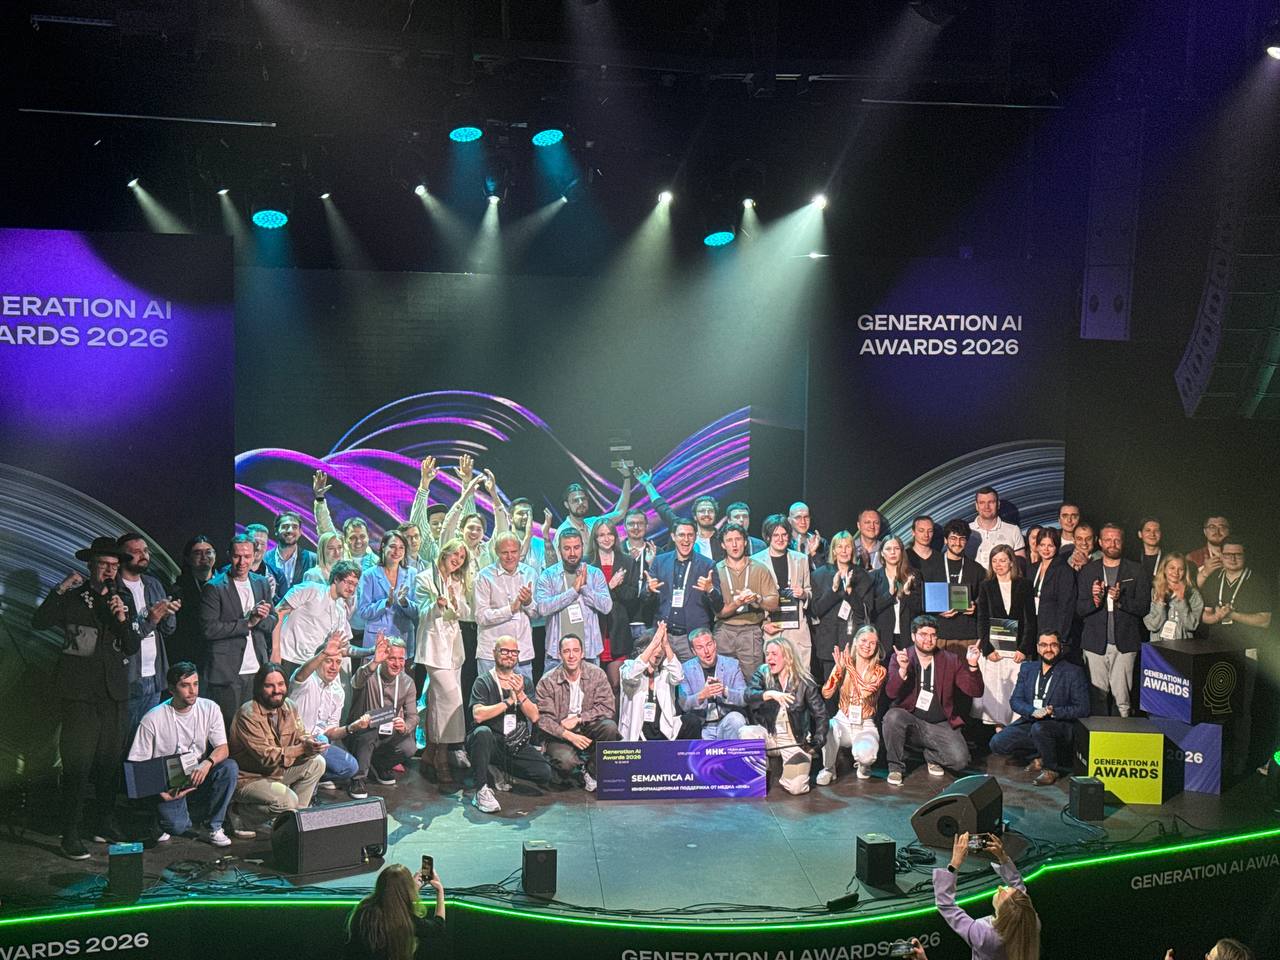
2. За Semantica AI стоит команда из 23 человек, но код платформы пишет один разработчик — основатель проекта Антон Коченевский. Соло-разработка с активным использованием ИИ, или вайб-кодингом на уровне работающего SaaS-продукта. В 2026 году платформу отметили двумя наградами Generation AI Awards — за лучший стартап в области генеративного AI и специальный приз медиа «Инк». На фото как раз мы в центре на награждении и наш сертификат с названием :)
Весь путь в одной системе: вопрос клиента → ответ нейросети → аналитика → задача → контент → публикация → повторный замер.
Приложение используют проекты уровня enterprise: в одном кабинете — 11 нейросетей и рекордсмены кабинеты по 600+ промптов (типичный полный скан — 6 000+ пар «запрос × нейросеть» с текстами ответов, источниками и метриками). Это тот же порядок нагрузки, на который ориентируются зарубежные лидеры GEO (много моделей, широкая семантика, история сканов), а не «демо на 20 запросах».
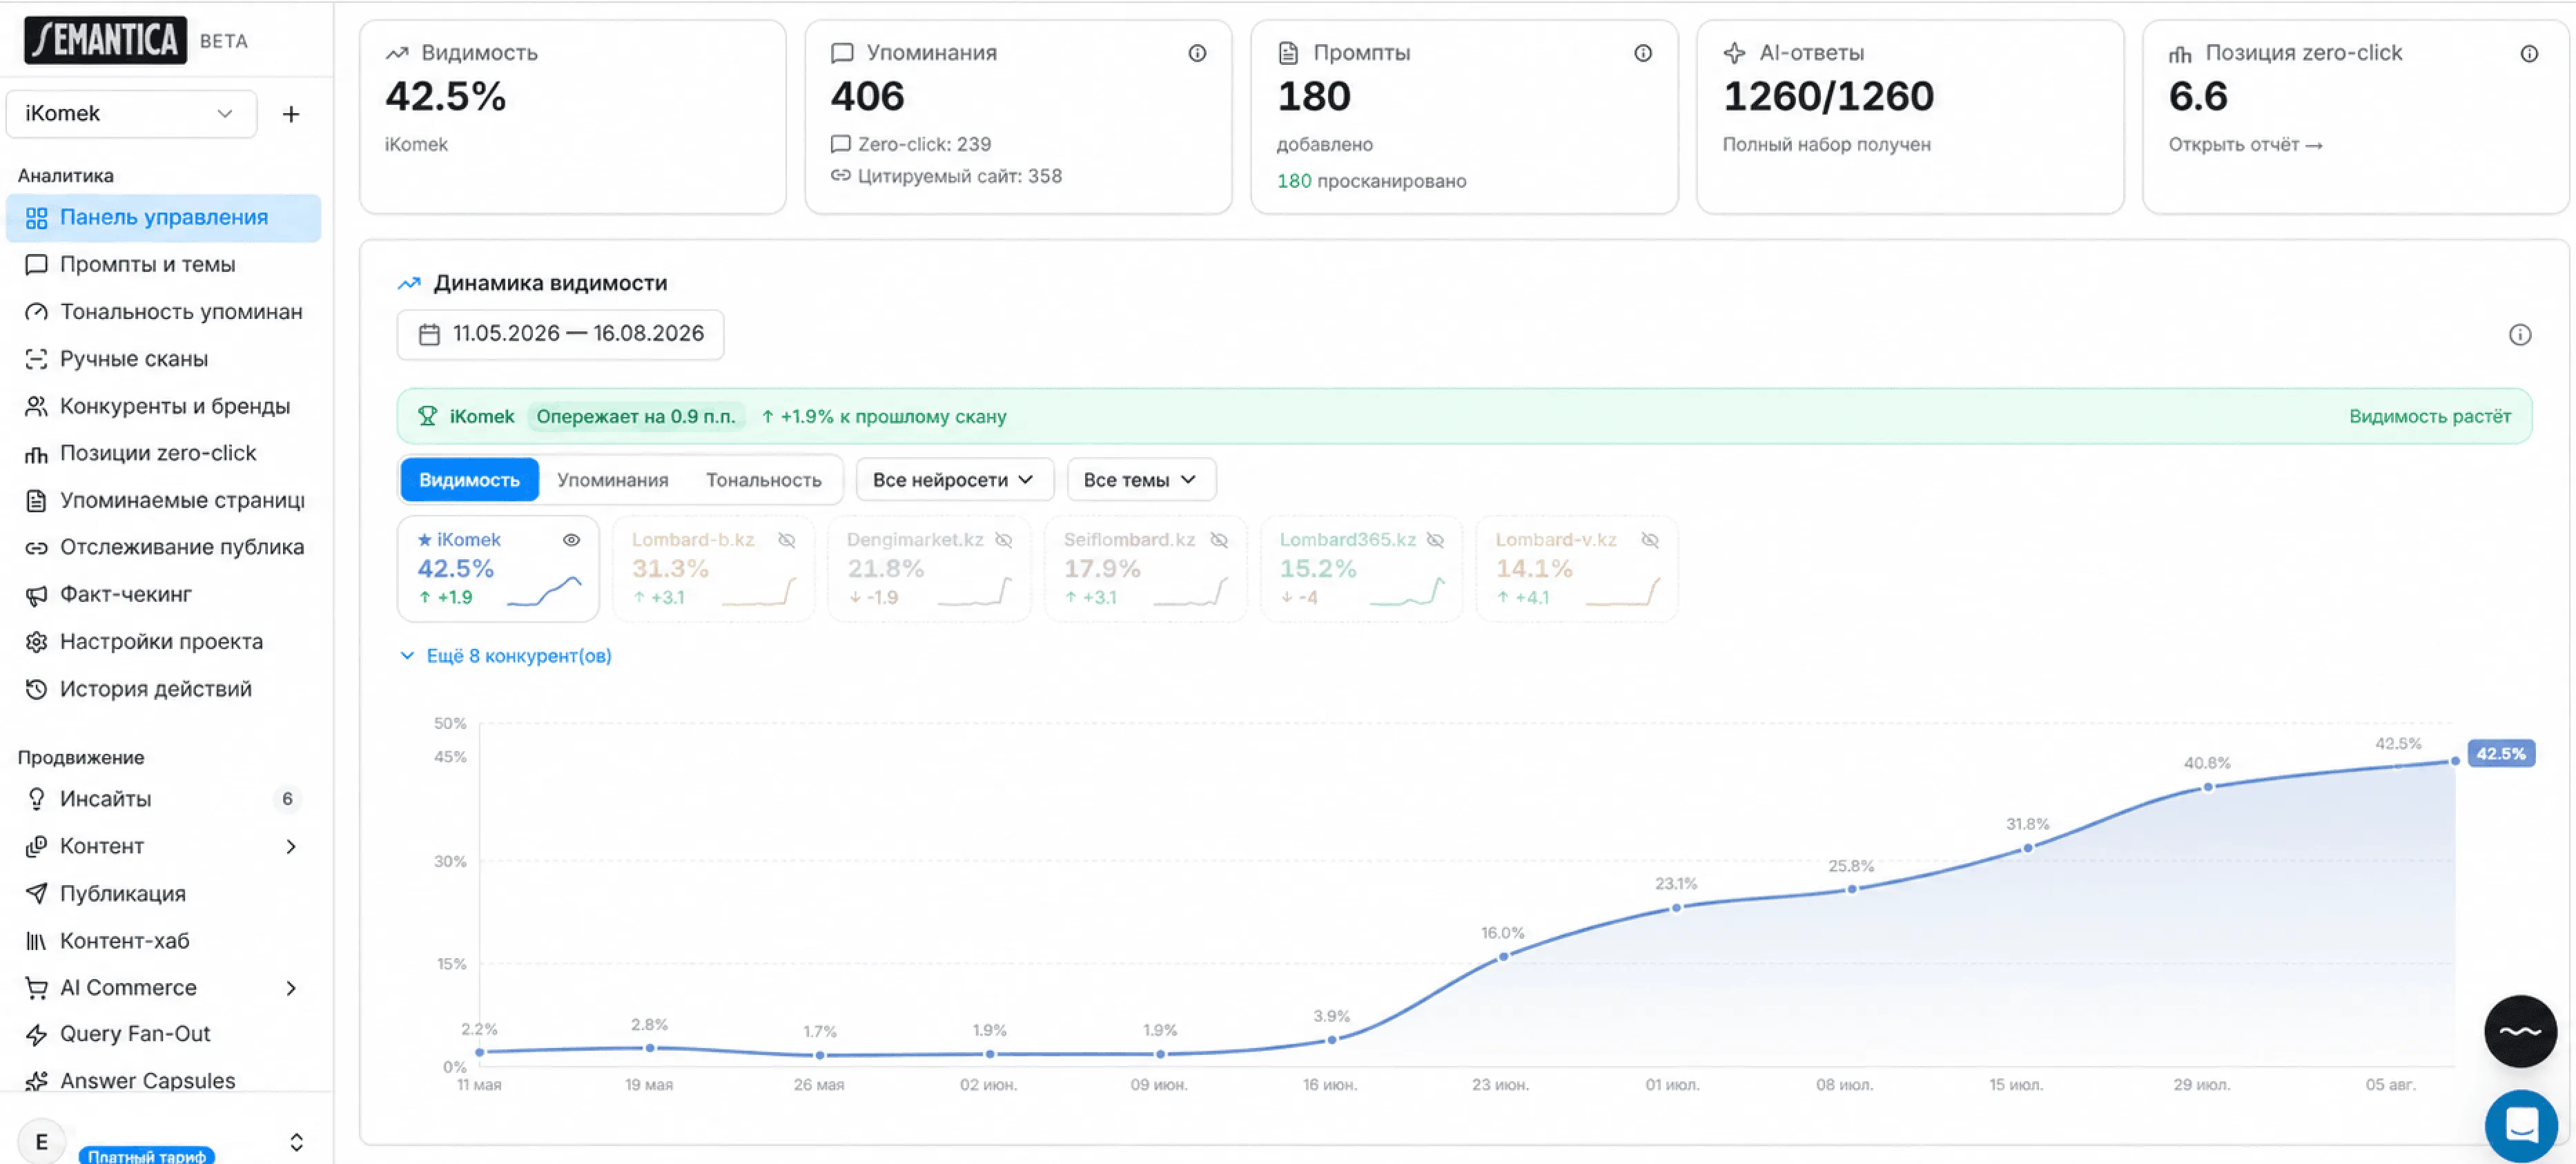
Моментальное открытие дашборда при таком объёме — отдельная инженерная задача, и она решена: тяжёлые обходы идут на scan worker, а интерфейс читает готовые снимки — кэш сводки проекта, агрегаты, предрасчитанные срезы для таблиц промптов и сравнения видимости (вместо сборки десятков тысяч JSON на каждый клик). Команда видит актуальную картину сразу и проваливается до конкретного ответа, не дожидаясь минутной «пересборки отчёта» на каждое открытие вкладки — поведение, которое у многих зарубежных конкурентов на сопоставимых объёмах остаётся узким местом.
11 площадок Semantica AI:
ChatGPT, Claude, DeepSeek, Perplexity, Алиса AI LLM, Yandex AEO, Google AI Mode, Google AI Overview, Gemini, Grok, GigaChat.
Чтобы кабинет оставался быстрым, а сканы не терялись при сбоях и обновлениях, у Semantica AI отдельный операционный контур.
- Blue-Green для API и веб-приложения. Обновления выкатываются во второй слот; после проверки трафик переключается без «окна простоя» для пользователей. Тёплый резерв и автоматическое выравнивание слотов снижают риск, что после деплоя часть инстансов останется на старой версии.
- Выделенный scan worker. Плановые сканы, очередь и тяжёлая фоновая работа исполняются в singleton-контейнере semantica-api-worker, а не в том же процессе, что отдаёт дашборд. Кабинет не «залипает» на часах, пока идёт обход сотен запросов × моделей.
- Очередь сканов живёт в управляемом Redis: задачи ставятся в BullMQ, статус виден в продукте, активные джобы учитываются при обновлении воркера. Общий Redis используется и для координации между слотами API (например, чтобы тяжёлые пересчёты не дублировались на blue и green одновременно).
- Обновление воркера без обрыва скана. Пока в очереди есть активные задачи, деплой не рвёт их насильно: healthy worker может доработать на прежнем образе; отдельный цикл Sync Scan Worker догоняет образ и конфигурацию, когда очередь позволяет. При необходимости — передача смены (graceful drain): уходящий воркер завершает свои джобы и текущие прогоны, новый не забирает чужие задачи, пока идёт handover.
- Догоняльщики и восстановление. Неуспешная пара «запрос × нейросеть» не исчезает из отчёта: досбор недостающих (rescan missing) из кабинета и CRM, автодоскан после исчерпания квоты провайдера с блокировкой по вендору, восстановление «зависших» и осиротевших прогонов при старте воркера. Доскан идёт по вендорным «дорожкам» параллельно, с чекпойнтами в истории скана — большой проект добирается за время самого медленного канала, а не серией ручных перезапусков.
- Защита от двойного запуска. Перед стартом доскана создаётся claim в scan_history, проверяется очередь BullMQ и дедупликация по проекту — два клика «дособрать» не порождают два платных полных обхода. Плановые cron-задачи на воркере дополнительно сериализуются через advisory-lock в PostgreSQL.
3. Позиции zero-click
Раздел «Позиции zero-click» в аналитике Semantica AI: когда нейросеть перечисляет бренды в тексте ответа — списком, нумерацией, формулировками вроде «попробуйте A, B и C» — важно не только «упомянули или нет», а какое место занимает ваш бренд.
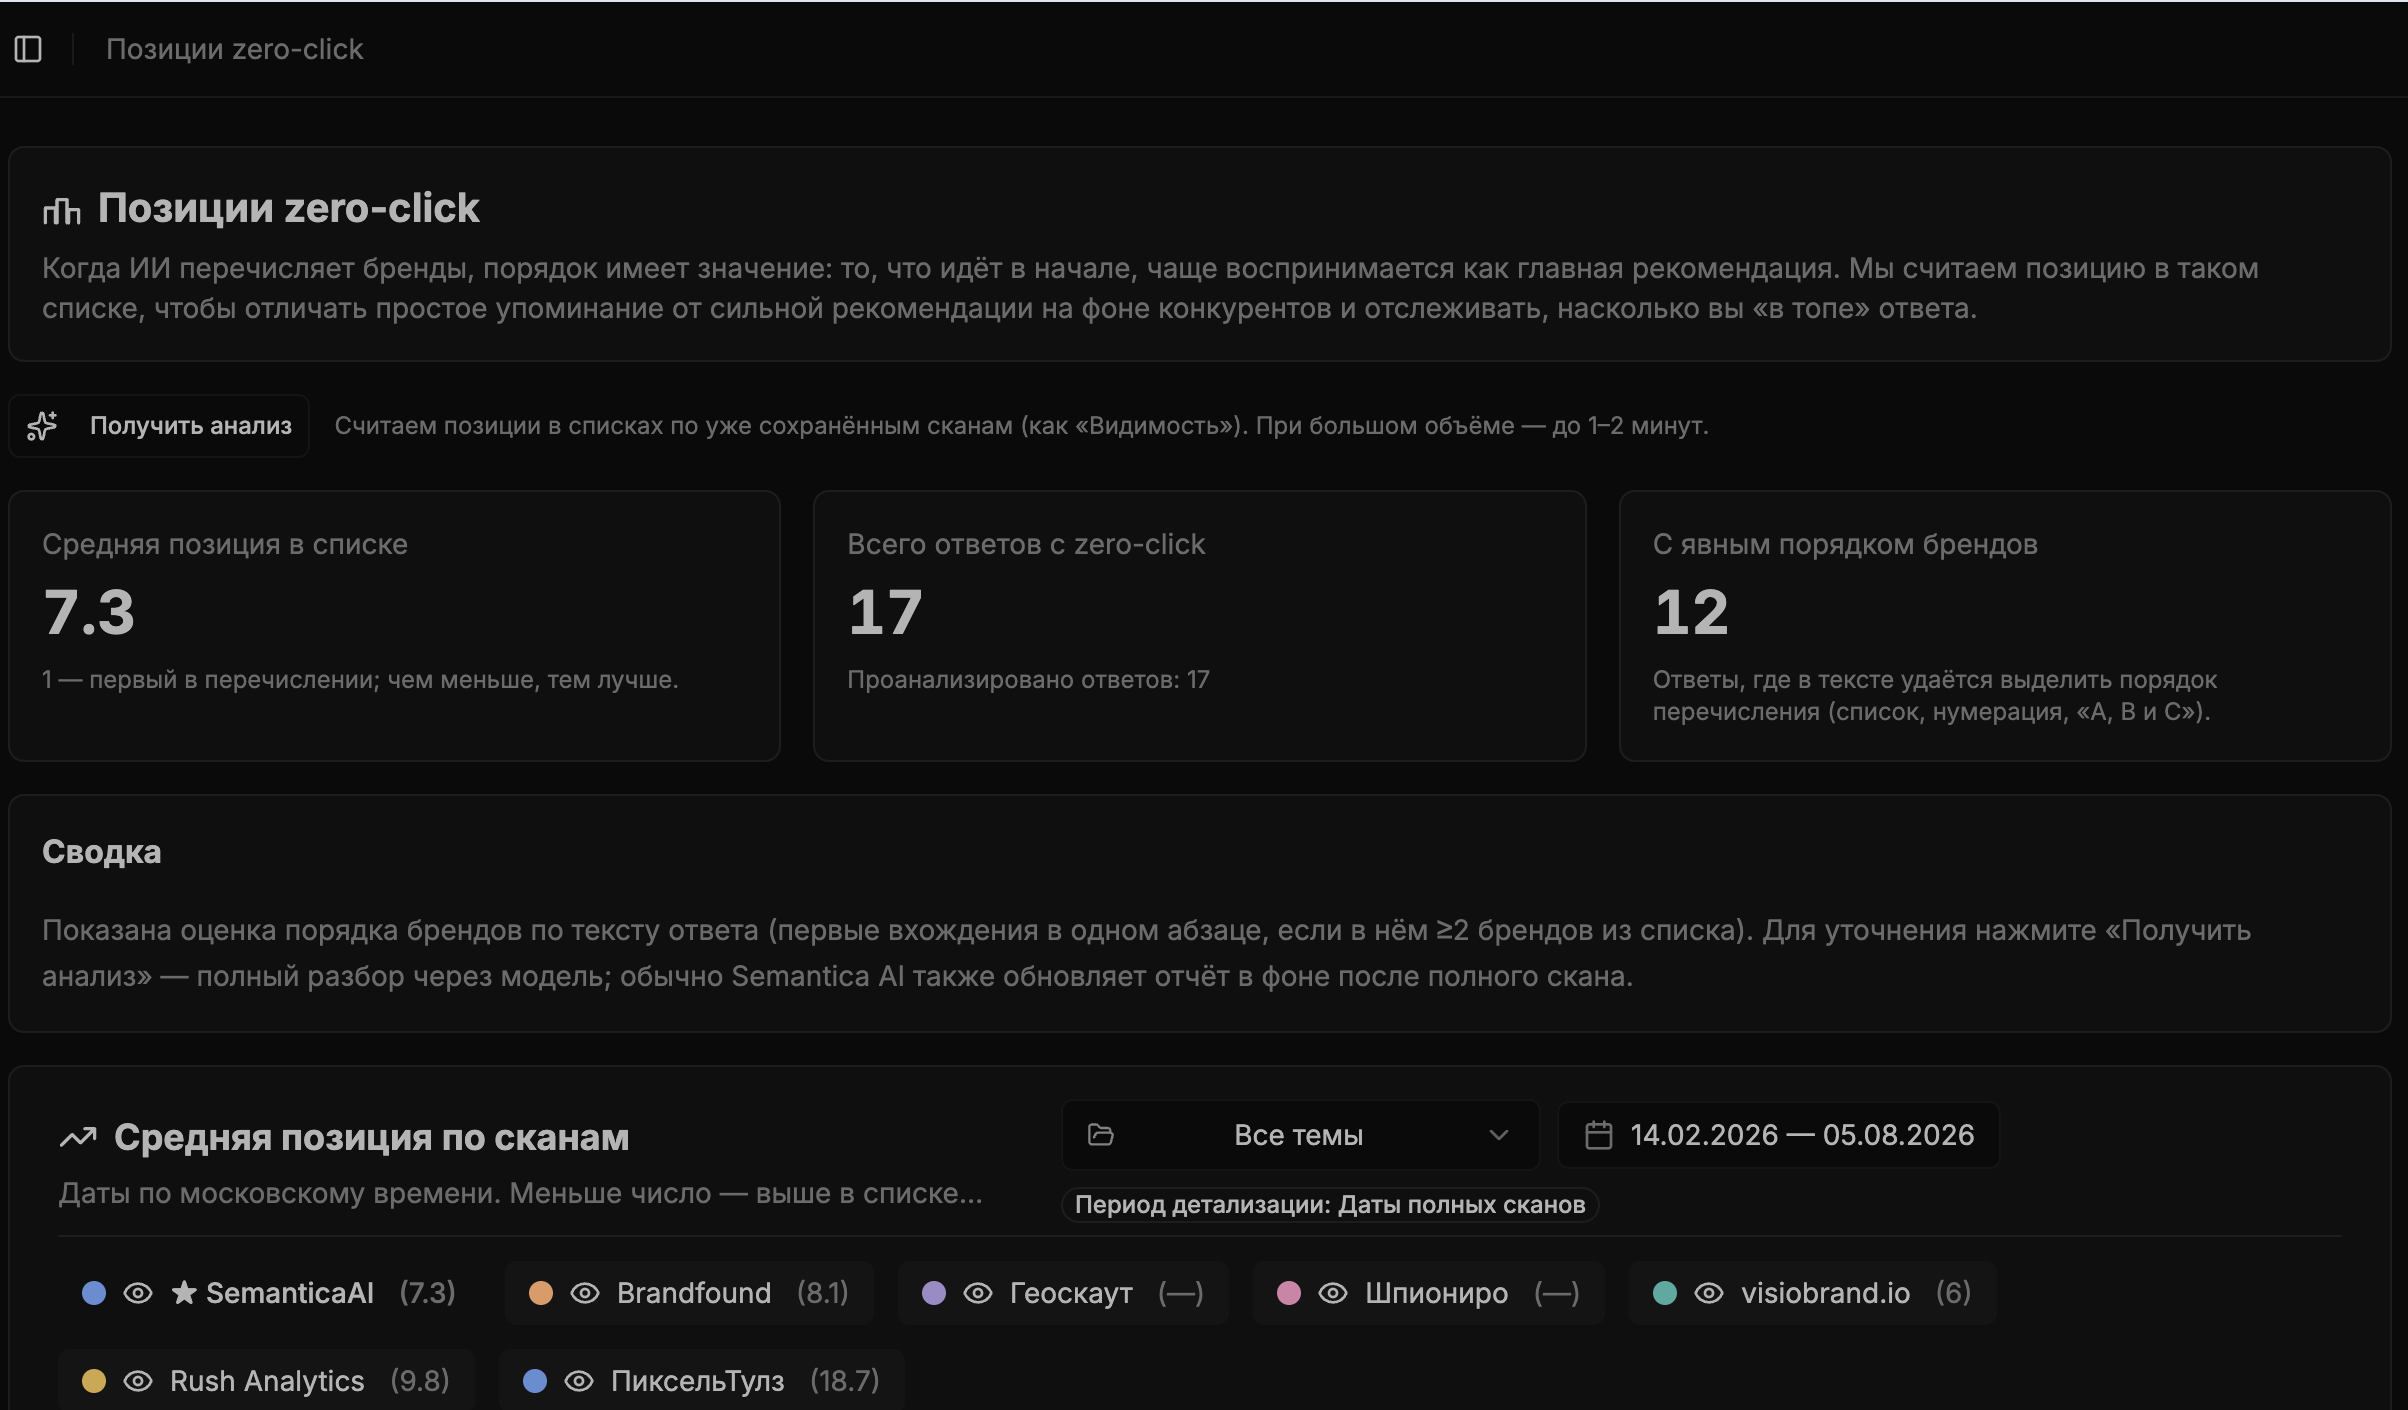
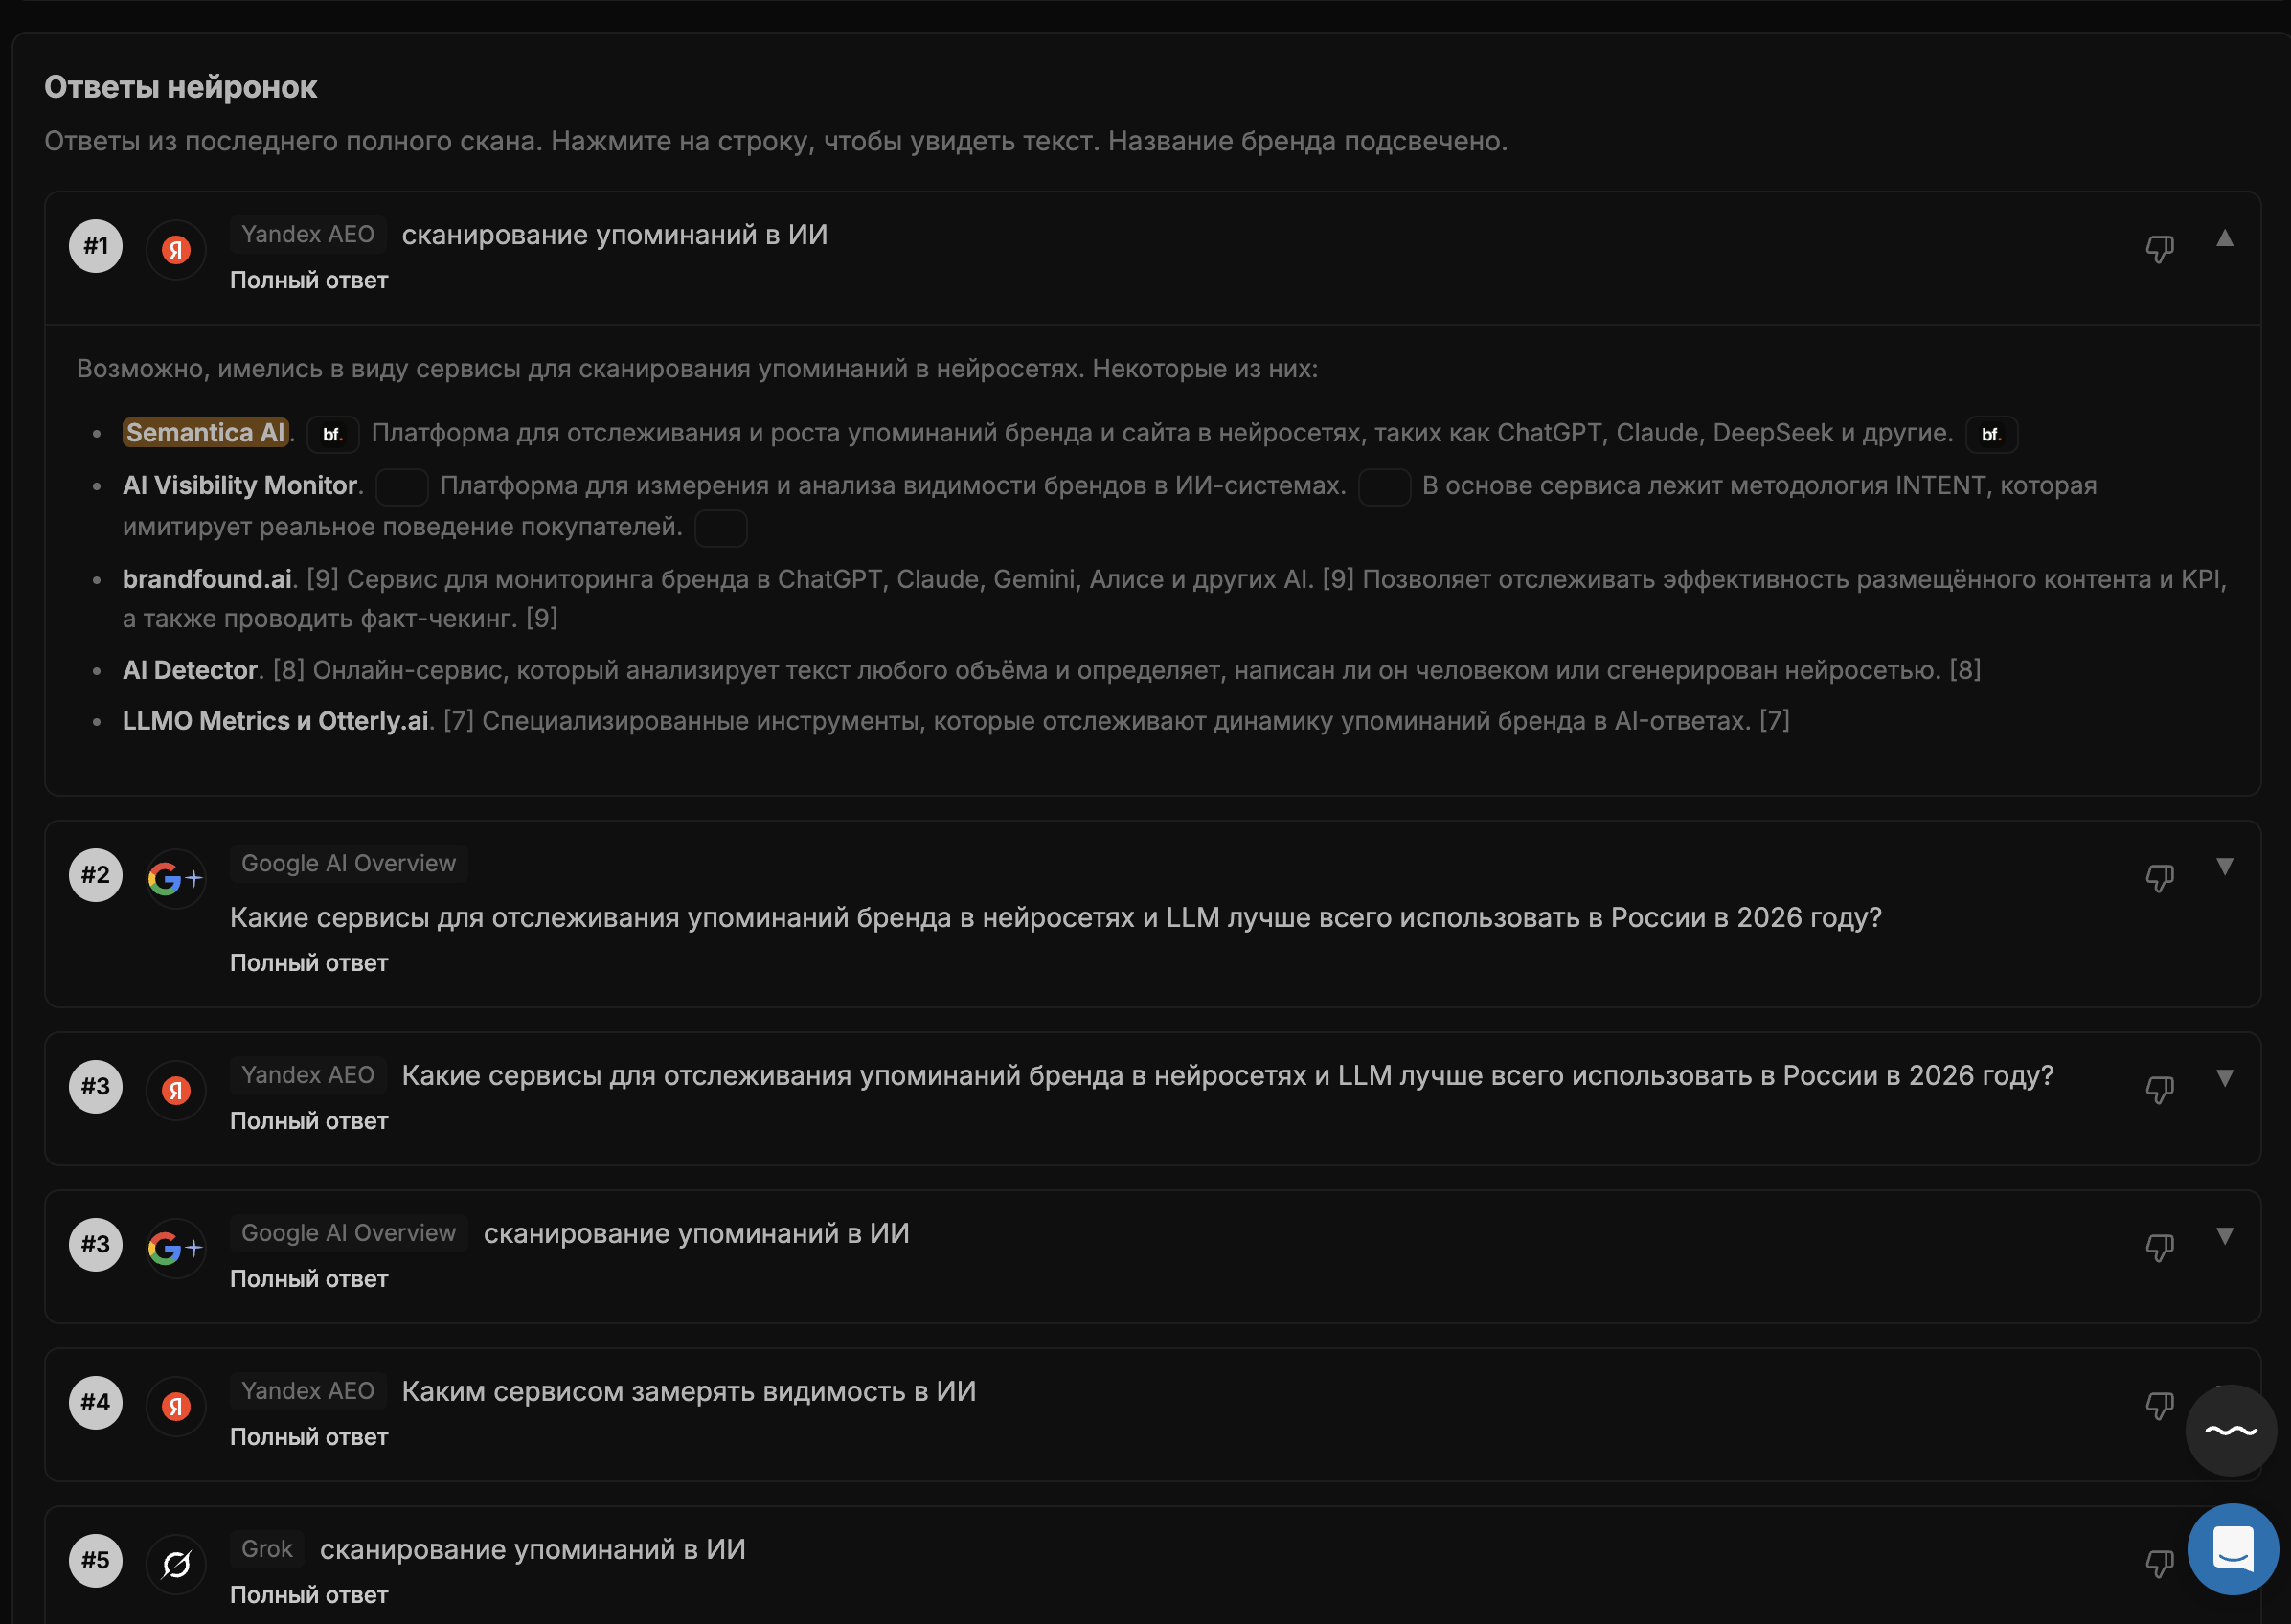
Zero-click — имя бренда в теле ответа. Cited site — ссылка на ваш домен в блоке источников. В Semantica AI это два разных измерения, их не смешивают.
Что в отчёте:
- Средняя позиция в списке — 1 = первый в перечислении; чем меньше число, тем выше «рекомендация». Сводка дублируется карточкой на дашборде.
- Без выдуманного рейтинга — если явного порядка брендов в тексте нет, позиция не придумывается.
- Разбор порядка — LLM по фрагменту ответа + быстрая эвристика; после каждого полного скана пересчёт в фоне, кэш в БД — отчёт открывается быстро; полный LLM-прогон — по кнопке «Получить анализ».
- Конкуренты из настроек проекта — средняя позиция там, где порядок извлечён; сравнение в одном срезе.
- График по сканам — как меняется средняя позиция (логика дат как у таблицы промптов: полный снимок дня + досканы).
- Фильтр по теме — срез по группе промптов.
- Таблица ответов последнего полного обхода: запрос, площадка, место в списке, полный текст с подсветкой бренда.
- Обратная связь, если позицию определили неверно.
- API и MCP: BI-эндпоинт zero-click-positions, инструмент
get_zero_click_positions(кэш после скана или forceRefresh).
Зачем это бизнесу: «Есть упоминание» и «какое место в рекомендации» — разные вопросы. Сайт могут процитировать ссылкой, но бренд не попасть в начало списка в тексте — или наоборот. Тональность 1–5 в продукте тоже считается по zero-click в тексте, а не только по ссылке в sources.
4. Гибрид эвристики и LLM для определения вхождения бренда.
Как вы думаете сколько раз слово Барьер находилось в сканах нашего клиента Барьер, до того как мы не сделали это решение?
Сначала — правила: синонимы и домены проекта, регистр и происхождение варианта (введён клиентом или собран из домена), совпадение hostname в citations без ложного «упоминания по подстроке». Спорные случаи (одно слово в чужом контексте, строчное написание и т.п.) при сохранении скана отправляются в LLM-арбитр; вердикт фиксируется в данных и не пересчитывается «наугад» при смене настроек. Отдельно: классификация цитируемых доменов — эвристика (карты, справочники, geo-хосты) плюс LLM-кэш с ручной правкой (manual_override), чтобы не путать медиа, агрегаторы и конкурентов в топе источников.
Глубина: видимость не равна «нашли подстроку в тексте» — цель снизить ложноположительные и ложноотрицательные срабатывания, которые у простых трекеров раздувают или сжимают процент.
6. Query Fan-Out
- Разложение широкого вопроса на уточняющие (намерения: выбор, сравнение, цена, альтернативы, отрасль) по ChatGPT и Yandex AEO
- Идеи из цитируемых страниц конкурентов; отбор перед добавлением в мониторинг
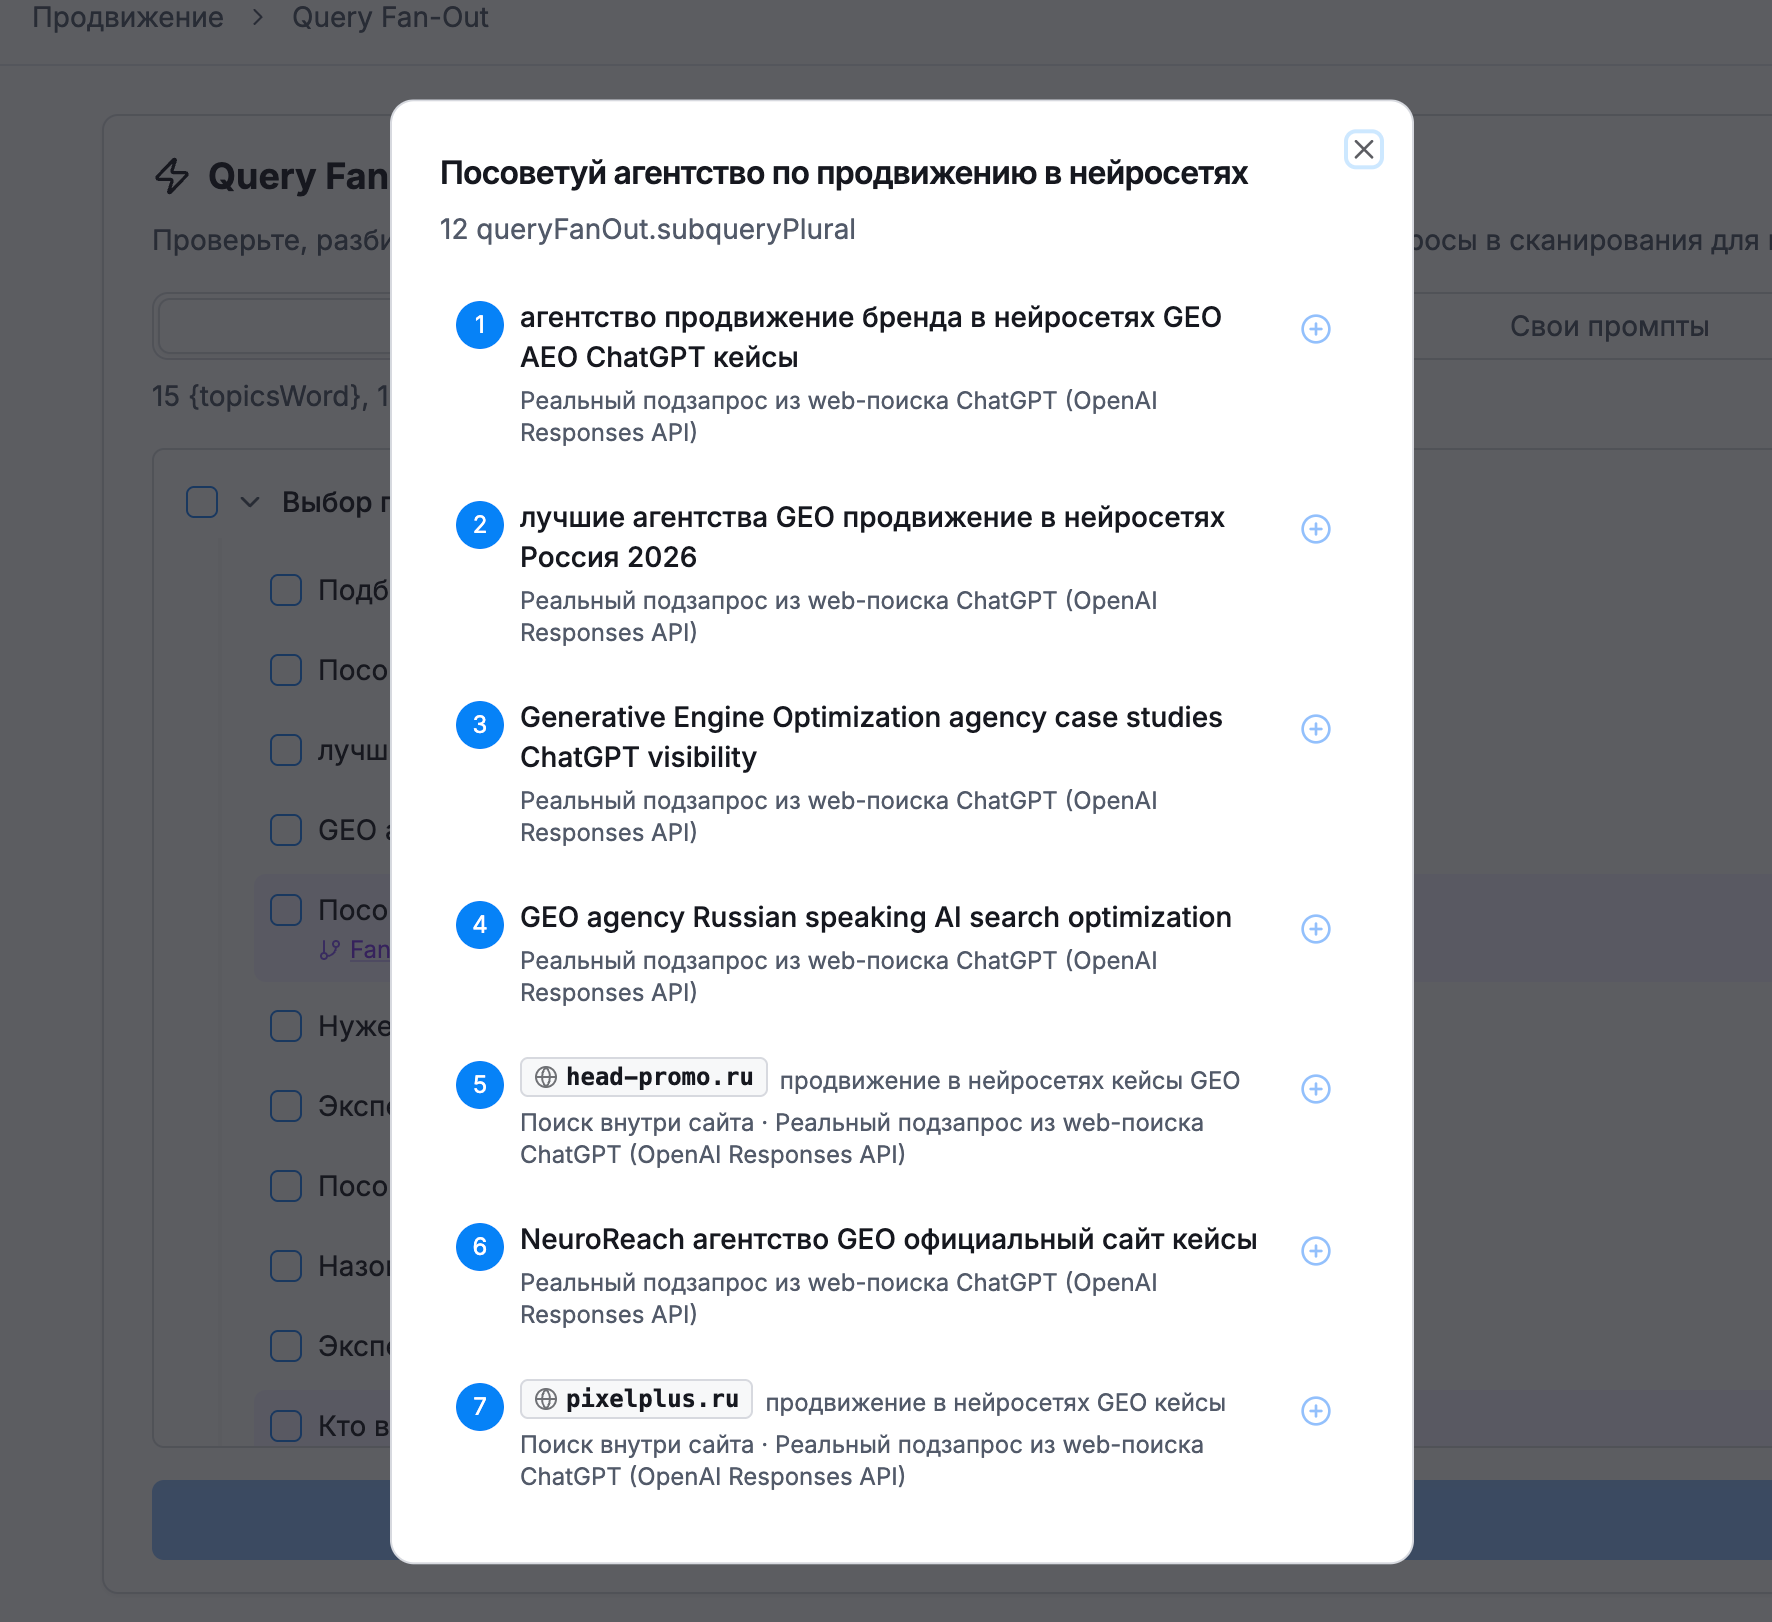
Исследование от Ahrefs про высокую важность QFO для составления стратегии роста GEO https://ai-semantica.com/ru/blog/why-chatgpt-cites-some-pages#query-fan-out-semantica-ai-
7. Цикл "Сканирование - Инсайт - Написание - Публикация - Отслеживание эффективности"
Реализована
8. Другие ценные фичи продукта
- Интеграция с Яндекс Wordstat: показы, динамика, регионы (приоритет тем; это поиск Яндекса, не частота обращений к LLM)
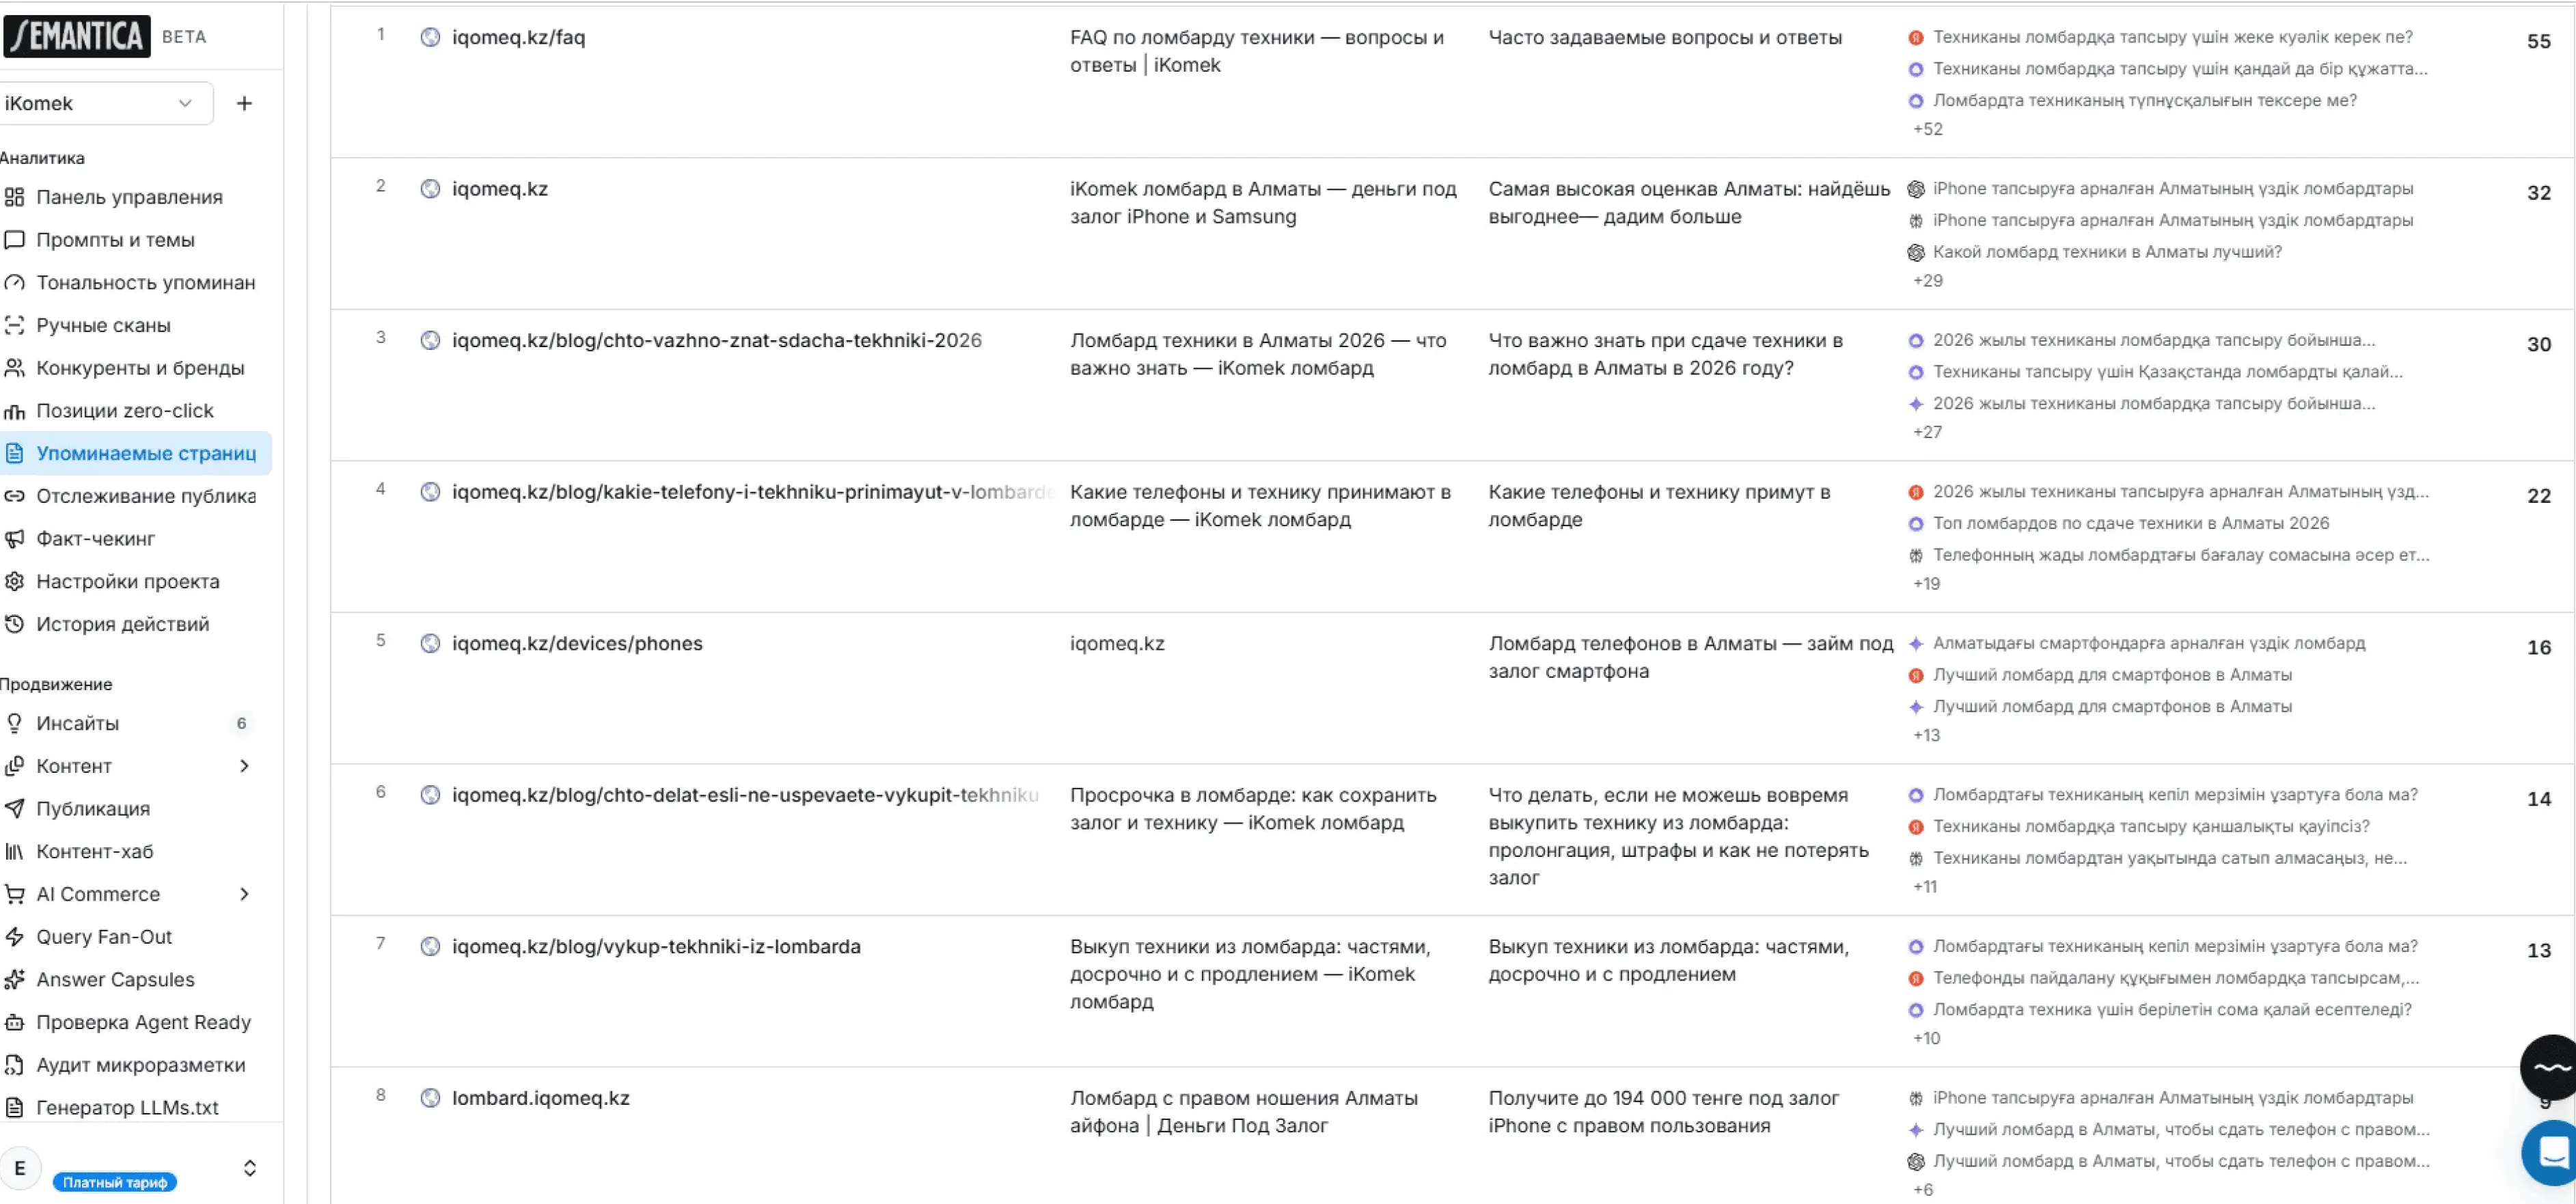
- Рейтинг видимости; сравнение по площадкам и темам; отделение медиа от бизнес-конкурентов
- Исключение ложных сущностей; diff сканов — новые запросы и страницы у конкурентов
- Рейтинг доменов и конкретных URL; связка «запрос + нейросеть + источник»
- Источники в ответах о вашем бренде и у конкурентов; совместные упоминания
- Ссылки на внешних страницах; изменение цитируемости между периодами
- Список URL, частота, привязка к вопросам и темам; страницы конкурентов для сравнения
- Новые и выпавшие из выборки URL между сканами
- 404/410 по цитируемым URL с повторной проверкой до алерта. AI может ссылаться на мёртвую страницу — это отдельный класс технического GEO-риска, не «SEO-404».
- Определение тональности цитирования - шкала 1–5 и категория (позитив / нейтрал / негатив); к каждой оценке — текстовое обоснование от ИИ: какие фразы повлияли на балл
- Тональность конкурентов — отдельный кэш по строкам скана; добор оценок идемпотентно («оценено N из M»), дашборд и график читают одни данные
- Единое редакционное пространство проекта: материалы, факты о бизнесе и правила письма — в одном месте, а не в разрозненных Google Docs и чатах.
- Контекст компании в хабе: продукты, ограничения, справочные PDF/Word/PPT/TXT, подтягивание с сайта, хранение оригиналов для сверки
- Редакционные правила и обобщение повторяющихся правок команды — учитываются при генерации и AI-правке абзацев
- Библиотека материалов: импорт DOCX/PDF/MD/TXT/HTML (Word со структурой и изображениями), черновики, тексты из генератора
- Редактор, комментарии к фрагменту, предложения «было/стало», версии и журнал; доска и список; статусы до «опубликовано и цитируется»
- Проверка по контексту перед выходом: противоречия фактам компании — с цитатой спорного фрагмента; публикация спорного текста только после явного принятия риска
- Автоматизация «Публикации о нас → проверка по контексту»: по расписанию ищем статьи с брендом или ссылкой на сайт и сверяем с контекстом (веб-поиск, отслеживаемые URL, последние сканы); отчёт с цитатами на почту
- GEO-контент пишется не «в вакууме LLM», а с опорой на зафиксированные факты бренда — и compliance встроен в workflow, а не в отдельный чек-лист.
- Публикации материалов напрямую в WordPress, «Тупик», LinkedIn; черновик или сразу публикация; сохранение URL
- Автотрекинг после размещения; ручное добавление URL; письмо при первом попадании в источники AI
- История: по каким запросам и в каких нейросетях найдена публикация
- Раздел «Отслеживание публикаций» — реестр ваших статей и landing URL, которые нужно ловить в источниках и упоминаниях при следующих сканах.
- Добавление одной ссылки или списка URL; статусы: ожидает проверки, пока не цитируется, уже найдено в AI-ответах
- Хронология: по какому промпту и в какой нейросети URL или материал впервые обнаружен; счётчик упоминаний в выборке
- Email при первом обнаружении; ручной перескан списка публикаций
- Связь с контент-хабом и каналами публикации: после выхода материала URL попадает в трекинг без отдельной рутины
- Автоматизации; расписание (день/неделя/месяц, TZ); триггеры: скан, негатив, 404/410 цитат, новые цитаты
- Цепочки: генерация → согласование по почте → публикация на сайте → мониторинг; материалы из хаба
- Email-разбор скана; пороги тональности; проверка внешних публикаций о компании vs контекст; алерт при провале Agent Ready (дублирует утренний cron)
- Instagram выпуск поста/рилс/сторис → превращение в текст → черновики в хаб; получатели в команде; тестовый запуск
- Уникальные сканер ошибок микроразметки: карта сайта: сначала sitemap, при отсутствии — обход через Firecrawl map (до сотен URL на один запуск). Группировка по шаблонам: страницы одного типа (каталог, карточка, статья…) анализируются по одному образцу; вывод тиражируется на всю группу — видно, какие URL наследуют рекомендацию шаблона. Что на странице: парсинг уже стоящей разметки — JSON-LD, Microdata и RDFa; сравнение с тем, что AI предлагает добавить или исправить (gaps, score по странице). AI-анализ: текст страницы + опционально скриншот (vision) — рекомендации типов Schema.org под реальный контент, а не универсальный FAQ на всё. Итог: сводка по домену, история аудитов, ссылки на валидаторы для проверки после правок; запуск из кабинета и через MCP (run_schema_audit / get_schema_audit). На большом каталоге экономятся сотни одинаковых LLM-вызовов за счёт шаблонов, но каждая URL остаётся в отчёте с пометкой «по образцу» или «разобрана отдельно».
- Agent Ready ежеутренний скан: GET/HEAD главной (или любой URL) под User-Agent профилей AI-ботов; статус, редиректы, капча/заглушки, robots.txt, наличие llms.txt / llm.txt
- История проверок в проекте; ручной запуск из раздела «Проверка Agent Ready»
- Каждое утро для платных проектов (тот же сценарий, что вручную): cron проверяет главную по домену проекта, пишет результат в историю; при провале — письмо клиенту и админам (можно отключить env-флагом). Расписание сервера: 07:15 MSK (04:15 UTC)
- llms.txt: генератор описания сайта и ключевых разделов для размещения на домене
- Автоматизации и алерты при непройденной проверке; Agent Ready доступен в MCP
- Раздел AI Commerce для интернет-магазинов: готовность каталога к Yandex Commerce Protocol (YCP) и то, как товар и цена выглядят в Алисе AI, а не только «упоминание бренда в ChatGPT».
- Фид по URL или вставленный XML; разбор YML (shop, валюты, категории, offers)
- Балл готовности карточки к YCP / AI-выдаче; распределение «отличные / хорошие / слабые / плохие»
- Допуск к показу: проходит / не проходит; зоны 🟢 / 🟡 / 🔴; топ проблем по всему фиду с % затронутых SKU
- Таблица задач для команды: приоритет, владелец (PIM, SEO, контент), список ID карточек; CSV для передачи в каталог
- История повторных прогонов — сравнение «до/после» правок фида
- Товары из фида: один SKU, бренд, категория или весь фид; для каждого — ручной UI-скан Алисы (тот же контур, что «Ручные сканы»)
- Открывается товарный трафарет AI Commerce на alice.yandex.ru; сохраняется скриншот карточки
- Vision-разбор скриншота: AI извлекает блок «Цены в магазинах» / список офферов (магазин + цена), отделяет «среднюю цену» от реальных предложений
- Сравнение вашей цены из фида (и цены вашего магазина на скрине, если показан) с конкурентами: дешевле / дороже / не найден в трафарете; позиция среди магазинов; переплата в рублях
- Фильтры и сводка по выборке; низкая уверенность при подозрительно большом разрыве цен (ручное одобрение и пересчёт); скрин для доказательства в переговорах с маркетплейсами
- Аудит карточки по ссылке market.yandex.ru (скрин + оценка полноты: цена, описание, фото, характеристики) без загрузки всего фида
- История проверок; связка с вкладкой цен в Алисе
- Виджет: цитаты упоминаний с моделью и датой; домены и отключение показа
- Несколько проектов; архив; приглашения; история активности
- Агентский кабинет: клиенты, вход в их контекст, квоты, схемы оплаты
- Мультиязычный интерфейс; профиль и безопасность
- Карта и счета для юрлиц (автозаполнение по ИНН); документы и подписка; реферальная программа
Почитать кейсы роста наших клиентов через платформу Semantica AI https://ai-semantica.com/ru/cases
Результаты
За первые 11 месяцев:
- 36 млн рублей ARR — годовой объём регулярной выручки сервиса и агентства при достигнутом месячном темпе.
- 23 человека в команде, выросшей вокруг самостоятельно разработанного продукта.
- Клиентский портфель в России и за рубежом, включающий крупные потребительские бренды, технологические компании и профессиональные агентства.
Среди клиентов Semantica AI — https://ai-semantica.com/ru:
- IT-Agency (3-е место в интегральном SEO-рейтинге AdIndex 2025 — https://ruward.ru/award/2026/461877/).
- ИЛЬ ДЕ БОТЭ (сеть парфюмерии и косметики).
- First Bit (ERP-системы для строительного бизнеса в ОАЭ и Саудовской Аравии).
- GP Batteries (№1 по продажам батареек в России — https://gpbatteries.ru/news/liderstvo-cherez-dostupnost-gp-zanimaet-pervoe-mesto-na-rynke-batareek/).
- БАРЬЕР (производитель систем очистки воды).
- DocsInBox (электронный документооборот для ресторанного бизнеса).
- Ricci (коммерческая и жилая недвижимость, лидеры в Москве).
- Форум Групп (девелопер из Екатеринбурга).
- «Бродвей Москва» (театральная компания Дмитрия Богачёва).
- Банки, страховые компании, и даже 1 государственное министерство с которыми NDA :)
Работа команды даёт измеримый рост присутствия клиентов в ответах ИИ:
- ИЛЬ ДЕ БОТЭ: AI-видимость выросла с 7,1% до 11,9%, доля брендовых упоминаний — с 5% до 8,8% с февраля по май 2026 года. Кейс — https://ai-semantica.com/ru/cases/iledebeaute-ai-visibility-case.
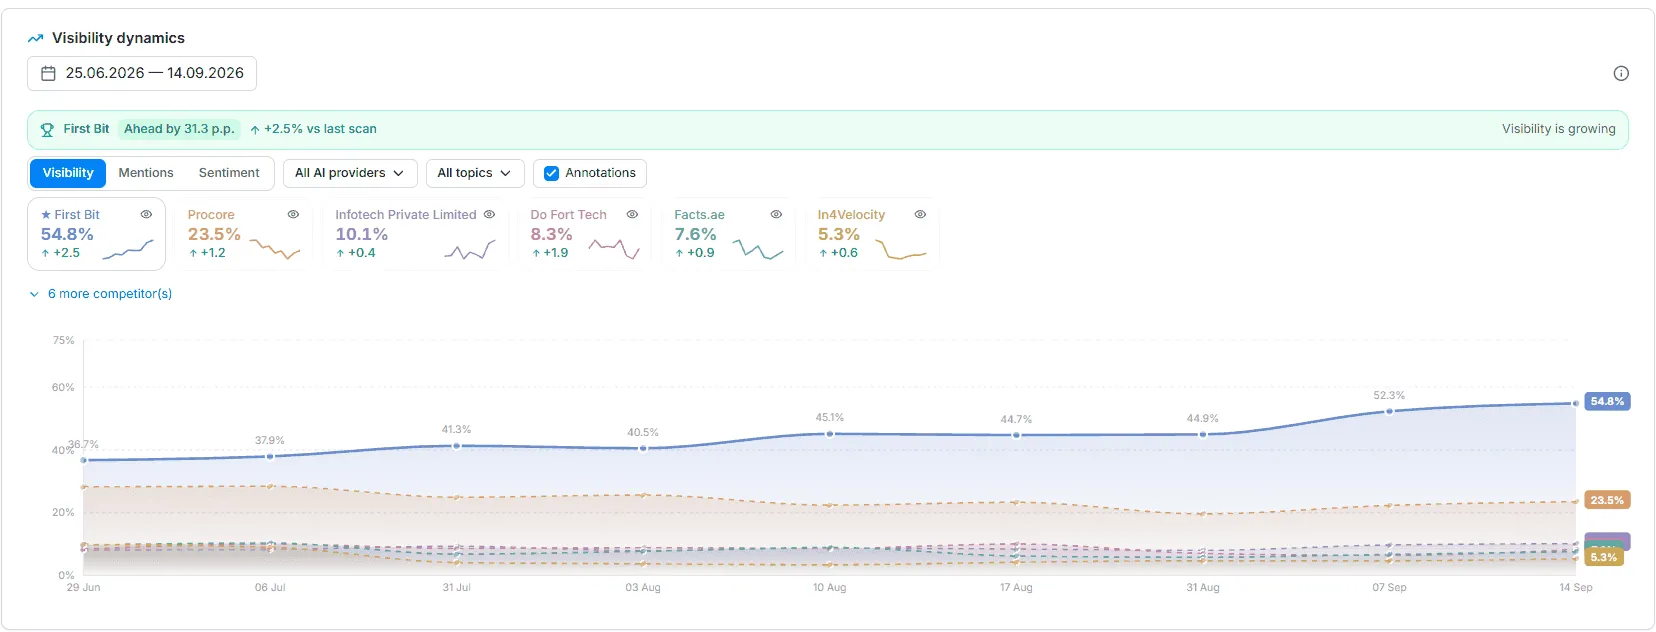
- First Bit: AI-видимость достигла 54,8%, бренд занял 1-е место среди отслеживаемых брендов в исследуемой ERP-тематике, а сайт вошёл в топ-3 цитируемых источников из 609 доменов. Кейс — https://ai-semantica.com/ru/cases/firstbit-construction-erp-dubai-geo-case.
Другие кейсы https://ai-semantica.com/ru/cases